# UDOP
## نظرة عامة
قُدم نموذج UDOP في [Unifying Vision, Text, and Layout for Universal Document Processing](https://huggingface.co/papers/2212.02623) من قِبل Zineng Tang وZiyi Yang وGuoxin Wang وYuwei Fang وYang Liu وChenguang Zhu وMichael Zeng وCha Zhang وMohit Bansal. يعتمد UDOP على بنية Transformer من نوع encoder-decoder مبنية على [T5](t5) لمهام الذكاء الاصطناعي المستندة إلى المستندات، مثل تصنيف صور المستندات، وتحليل المستندات، والإجابة البصرية على أسئلة المستندات.
المستخلص من الورقة البحثية هو كالتالي:
نقترح نموذج الذكاء الاصطناعي التأسيسي للمعالجة الشاملة للمستندات (UDOP)، وهو نموذج يوحّد بين أنماط النص والصورة والتخطيط مع تنويع صيغ المهام، بما في ذلك فهم المستندات وتوليدها. يستفيد UDOP من الارتباط المكاني بين المحتوى النصي وصورة المستند لنمذجة أنماط الصورة والنص والتخطيط باستخدام تمثيل موحد واحد. ومن خلال محول رؤية-نص-تخطيط (Vision-Text-Layout Transformer) مبتكر، يوحّد UDOP بين ما قبل التدريب والمهام متعددة المجالات التي تليها في مخطط توليد تسلسلي قائم على التلميحات (prompts). يخضع UDOP لما قبل التدريب على كلا من مجموعات بيانات المستندات غير الموسومة واسعة النطاق باستخدام أهداف ذاتية الإشراف مبتكرة، وعلى بيانات موسومة متنوعة. كما يتعلم UDOP توليد صور المستندات من أنماط النص والتخطيط عبر إعادة بناء الصور المقنّعة (masked image reconstruction). وإلى حد علمنا، هذه هي المرة الأولى في مجال الذكاء الاصطناعي للمستندات التي يحقق فيها نموذج واحد في آنٍ واحد تحريرًا عصبيًا عالي الجودة للمستندات وتخصيصًا للمحتوى. تحقّق منهجيتنا مستوى الأداء الحالي (state-of-the-art) في 9 مهام للذكاء الاصطناعي للمستندات، مثل فهم المستندات والأسئلة والأجوبة، عبر مجالات بيانات متنوعة مثل التقارير المالية والأوراق الأكاديمية والمواقع الإلكترونية. يحتل UDOP المرتبة الأولى في لوحة الصدارة لمعيار فهم المستندات (DUE).*
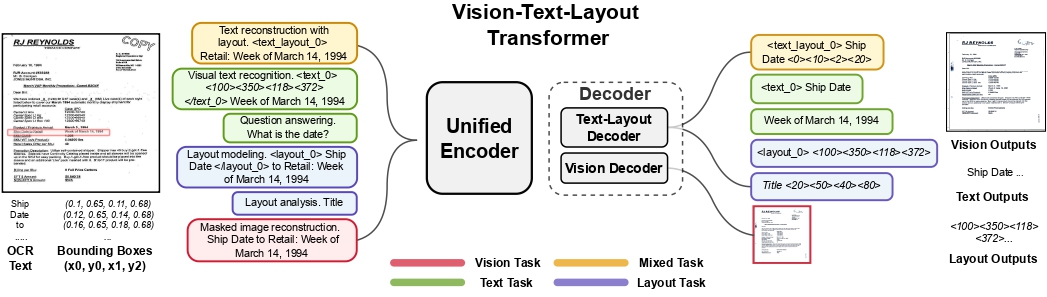 بنية UDOP. مأخوذة من الورقة الأصلية.
## نصائح للاستخدام
- بالإضافة إلى *input_ids*، يتوقع [UdopForConditionalGeneration](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopForConditionalGeneration) أيضاً إدخال `bbox`، وهي صناديق الحدود (أي المواضع ثنائية الأبعاد) للرموز المدخلة. يمكن الحصول عليها باستخدام محرك OCR خارجي مثل [Tesseract](https://github.com/tesseract-ocr/tesseract) من Google (يتوفر [Python wrapper](https://pypi.org/project/pytesseract/) لذلك). يجب أن يكون كل صندوق حدود بصيغة (x0, y0, x1, y1)، حيث يتوافق (x0, y0) مع موضع الزاوية العلوية اليسرى في صندوق الحدود، ويمثل (x1, y1) موضع الزاوية السفلية اليمنى. لاحظ أنه يجب أولاً تطبيع صناديق الحدود لتكون على مقياس من 0 إلى 1000. للتطبيع، يمكنك استخدام الدالة التالية:
```python
def normalize_bbox(bbox, width, height):
return [
int(1000 * (bbox[0] / width)),
int(1000 * (bbox[1] / height)),
int(1000 * (bbox[2] / width)),
int(1000 * (bbox[3] / height)),
]
```
هنا، `width` و`height` يتوافقان مع عرض وارتفاع المستند الأصلي الذي يظهر فيه الرمز. يمكن الحصول عليهما باستخدام مكتبة Python Image Library (PIL) على سبيل المثال، على النحو التالي:
```python
from PIL import Image
# Document can be a png, jpg, etc. PDFs must be converted to images.
image = Image.open(name_of_your_document).convert("RGB")
width, height = image.size
```
يمكن استخدام [UdopProcessor](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopProcessor) لتحضير الصور والنصوص للنموذج، حيث يتولى هذا الأمر بالكامل. افتراضياً، تستخدم هذه الفئة محرك Tesseract لاستخراج قائمة بالكلمات والصناديق (الإحداثيات) من مستند معيّن. وتكافئ وظيفتها وظيفة [LayoutLMv3Processor](/docs/transformers/v5.23.0/ar/model_doc/layoutlmv3#transformers.LayoutLMv3Processor)، لذا فهي تدعم تمرير `apply_ocr=False` إذا كنت تفضّل استخدام محرك OCR خاص بك، أو `apply_ocr=True` إذا كنت تريد استخدام محرك OCR الافتراضي. راجع [دليل استخدام LayoutLMv2](layoutlmv2#usage-layoutlmv2processor) لمعرفة جميع حالات الاستخدام الممكنة (حيث أن وظيفة `UdopProcessor` متطابقة تماماً).
- إذا كنت تستخدم محرك OCR خاصًا بك، فإن أحد التوصيات هو [Read API](https://learn.microsoft.com/en-us/azure/ai-services/computer-vision/how-to/call-read-api) من Azure، والذي يدعم ما يُسمى بالمقاطع السطرية. يؤدي استخدام تضمينات موضع المقاطع عادةً إلى أداء أفضل.
- عند الاستدلال، يُوصى باستخدام طريقة `generate` لتوليد النص بشكل ذاتي التراجع بناءً على صورة مستند.
- تم تدريب النموذج مسبقًا على كلا الهدفين: الإشرافي الذاتي والإشرافي. يمكن استخدام بادئات المهام (الموجّهات) المختلفة المستخدمة أثناء التدريب المسبق لاختبار القدرات الجاهزة للاستخدام. على سبيل المثال، يمكن توجيه النموذج بعبارة "إجابة الأسئلة. ما هو التاريخ؟"، حيث أن "إجابة الأسئلة." هي بادئة المهمة المستخدمة أثناء التدريب المسبق لـ DocVQA. راجع [الورقة البحثية](https://huggingface.co/papers/2212.02623) (الجدول 1) لجميع بادئات المهام.
- يمكن أيضًا ضبط [UdopEncoderModel](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopEncoderModel)، وهو الجزء الخاص بالمُشفِّر فقط في UDOP، والذي يمكن اعتباره مُشفِّر Transformer مشابهًا لـ LayoutLMv3. للمهام التمييزية، يكفي إضافة مُصنِّف خطي فوقه وضبطه على مجموعة بيانات مُوسومة.
تمت مساهمة هذا النموذج من قِبل [nielsr](https://huggingface.co/nielsr). يمكن العثور على الكود الأصلي [هنا](https://github.com/microsoft/UDOP).
## الموارد
قائمة بالموارد الرسمية من Hugging Face وموارد المجتمع (المشار إليها بـ 🌎) لمساعدتك على البدء مع UDOP. إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب (Pull Request) وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
- يمكن العثور على كراسات تجريبية تتعلق بـ UDOP [هنا](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/UDOP) تُظهر كيفية
لضبط UDOP على مجموعة بيانات مخصصة وكذلك الاستدلال. 🌎
- [دليل مهمة الإجابة عن الأسئلة من المستندات](../tasks/document_question_answering)
## UdopConfig[[transformers.UdopConfig]]
#### transformers.UdopConfig[[transformers.UdopConfig]]
```python
transformers.UdopConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, vocab_size: int = 33201, d_model: int = 1024, d_kv: int = 64, d_ff: int = 4096, num_layers: int = 24, num_decoder_layers: int | None = None, num_heads: int = 16, relative_attention_num_buckets: int = 32, relative_attention_max_distance: int = 128, relative_bias_args: list[dict] | None = None, dropout_rate: float | int = 0.1, layer_norm_epsilon: float = 1e-06, initializer_factor: float = 1.0, feed_forward_proj: str = 'relu', use_cache: bool = True, pad_token_id: int | None = 0, eos_token_id: int | list[int] | None = 1, max_2d_position_embeddings: int = 1024, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, is_decoder: bool = False, add_cross_attention: bool = False, tie_word_embeddings: bool = True)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/configuration_udop.py#L24)
**المعاملات:**
is_encoder_decoder (`bool`، *اختياري*، الافتراضي هو `True`) : ما إذا كان النموذج يُستخدم كمُشفِّر/مُفكِّك أم لا.
vocab_size (`int`، *اختياري*، القيمة الافتراضية `33201`) : حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطة `input_ids`.
d_model (`int`, *اختياري*, القيمة الافتراضية هي `1024`) : حجم طبقات المُرمِّز وطبقة المُجمِّع.
d_kv (`int`، *اختياري*، القيمة الافتراضية `64`) : حجم إسقاطات المفتاح والاستعلام والقيمة لكل رأس انتباه. سيتم تعريف `inner_dim` لطبقة الإسقاط على أنه `num_heads * d_kv`.
d_ff (`int`، *اختياري*، القيمة الافتراضية `4096`) : بُعد تمثيلات MLP.
num_layers (`int`، *اختياري*، القيمة الافتراضية `24`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_decoder_layers (`int`, *اختياري*) : عدد الطبقات المخفية في مُفكِّك Transformer. سيُستخدم نفس قيمة `num_layers` إذا لم يتم ضبطه.
num_heads (`int`، *اختياري*، القيمة الافتراضية `16`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
relative_attention_num_buckets (`int`، *اختياري*، القيمة الافتراضية 32) : عدد الدلاء المستخدمة لكل طبقة انتباه.
relative_attention_max_distance (`int`، *اختياري*، القيمة الافتراضية 128) : الحد الأقصى للمسافة للترتيبات الأطول لفصل الدلاء.
relative_bias_args (`list[dict]`، *اختياري*، القيمة الافتراضية هي `[{'type' : '1d'}, {'type': 'horizontal'}, {'type': 'vertical'}]`): قائمة من القواميس تحتوي على الحُجج الخاصة بطبقات التحيز النسبي.
dropout_rate (`Union[float, int]`، *اختياري*، القيمة الافتراضية هي `0.1`) : النسبة لجميع طبقات dropout.
layer_norm_epsilon (`float`, *اختياري*, الافتراضي هو `1e-06`) : قيمة إيبسلون المستخدمة في طبقات تطبيع الطبقة.
initializer_factor (`float`، *اختياري*، القيمة الافتراضية `1.0`) : معامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة).
feed_forward_proj (`string`، *اختياري*، القيمة الافتراضية `"relu"`) : نوع طبقة التقدّم الأمامي (feed forward) التي سيتم استخدامها. يجب أن يكون أحد `"relu"` أو `"gated-gelu"`. يستخدم Udopv1.1 إسقاط التقدّم الأمامي `"gated-gelu"`. بينما يستخدم Udop الأصلي `"relu"`.
use_cache (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب على النموذج إرجاع قيم المفاتيح/القيم الأخيرة للانتباه (لا تستخدمها جميع النماذج). لا ينطبق إلا إذا كان `config.is_decoder=True` أو عندما يكون النموذج نموذجًا توليديًا يعتمد على المُفكِّك فقط.
pad_token_id (`int`، *اختياري*، القيمة الافتراضية `0`) : معرّف الرمز المستخدم للتعبئة في المفردات.
eos_token_id (`Union[int, list[int]]`، *اختياري*، الافتراضي هو `1`) : معرّف الرمز المستخدم لنهاية البث في المفردات.
max_2d_position_embeddings (`int`، *اختياري*، القيمة الافتراضية 1024) : الحد الأقصى لتضمينات الموضع المطلق لتشفير الموضع النسبي.
image_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `224`) : حجم (دقة) كل صورة.
patch_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `16`) : حجم (دقة) كل رقعة.
num_channels (`int`، *اختياري*، القيمة الافتراضية `3`) : عدد قنوات الإدخال.
is_decoder (`bool`، *اختياري*، الافتراضي `False`) : ما إذا كان النموذج يُستخدم كمُفكِّك أم لا. إذا كان `False`، يُستخدم النموذج كمُشفِّر.
add_cross_attention (`bool`, *اختياري*, الافتراضي هو `False`) : ما إذا كان يجب إضافة طبقات الانتباه المتقاطع إلى النموذج.
tie_word_embeddings (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب ربط ترميزات الأوزان وفقاً لخريطة `tied_weights_keys` الخاصة بالنموذج.
هذه فئة الإعدادات المخزنة لإعدادات نموذج UdopModel. تُستخدم لاستحداث نموذج Udop وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [microsoft/udop-large](https://huggingface.co/microsoft/udop-large)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
## UdopTokenizer[[transformers.UdopTokenizer]]
#### transformers.UdopTokenizer[[transformers.UdopTokenizer]]
```python
transformers.UdopTokenizer(vocab: str | list[tuple[str, float]] | None = None, eos_token = '', sep_token = '', unk_token = '', pad_token = '', sep_token_box = [1000, 1000, 1000, 1000], pad_token_box = [0, 0, 0, 0], pad_token_label = -100, only_label_first_subword = True, extra_special_tokens = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/tokenization_udop.py#L139)
**المعاملات:**
eos_token (`str`، *اختياري*، القيمة الافتراضية `""`) : رمز نهاية التسلسل. عند بناء تسلسل باستخدام الرموز الخاصة، هذا ليس الرمز المستخدم لنهاية التسلسل. الرمز المستخدم هو `sep_token`.
sep_token (`str`، *اختياري*، الافتراضي هو `""`) : رمز الفاصل، الذي يُستخدم عند بناء تسلسل من عدة تسلسلات، مثل تسلسلين لتصنيف التسلسلات، أو نص وسؤال للإجابة على الأسئلة. كما يُستخدم كآخر رمز في تسلسل مبني برموز خاصة.
unk_token (`str`، *اختياري*، القيمة الافتراضية `""`) : رمز المجهول. الرمز غير الموجود في قاموس الكلمات لا يمكن تحويله إلى معرّف، لذا يُعيَّن هذا الرمز بدلاً منه.
pad_token (`str`، *اختياري*، القيمة الافتراضية هي `""`) : الرمز المستخدم للتعبئة، على سبيل المثال عند تجميع تسلسلات ذات أطوال مختلفة.
sep_token_box (`list[int]`، *اختياري*، القيمة الافتراضية `[1000, 1000, 1000, 1000]`) : صندوق الحدود (bounding box) الذي سيُستخدم للرمز الخاص [SEP].
pad_token_box (`list[int]`، *اختياري*، القيمة الافتراضية `[0, 0, 0, 0]`) : الصندوق المحيط (bounding box) الذي سيُستخدم للرمز الخاص [PAD].
pad_token_label (`int`، *اختياري*، القيمة الافتراضية -100) : التسمية المستخدمة لرموز الحشو. القيمة الافتراضية هي -100، وهي `ignore_index` في CrossEntropyLoss الخاصة بـ PyTorch.
only_label_first_subword (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب وضع التسمية على أول جزء من الكلمة فقط، في حال تم توفير تسميات الكلمات.
extra_special_tokens (`list[str]`، *اختياري*، القيمة الافتراضية هي `["
NOTUSED", "NOTUSED"]`) : رموز خاصة إضافية يستخدمها مُجزِّئ النص.
أنشئ مُجزِّئ UDOP "سريع" (مدعوم بمكتبة *tokenizers* من HuggingFace). مُعدَّل من [LayoutXLMTokenizer](/docs/transformers/v5.23.0/ar/model_doc/layoutxlm#transformers.LayoutXLMTokenizer) و[T5Tokenizer](/docs/transformers/v5.23.0/ar/model_doc/t5#transformers.T5Tokenizer). مبني على [BPE](https://huggingface.co/docs/tokenizers/python/latest/components.html?highlight=BPE#models).
يرث هذا المُجزِّئ من [TokenizersBackend](/docs/transformers/v5.23.0/ar/main_classes/tokenizer#transformers.TokenizersBackend) التي تحتوي على معظم الدوال الرئيسية. ينبغي على المستخدمين الرجوع إلى هذه الفئة الأصلية لمزيد من المعلومات حول تلك الدوال.
#### build_inputs_with_special_tokens[[transformers.UdopTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list[int], token_ids_1: list[int] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/tokenization_udop.py#L972)
**المعاملات:**
token_ids_0 (`list[int]`) : قائمة بالمعرّفات التي ستُضاف إليها الرموز الخاصة.
token_ids_1 (`list[int]`، *اختياري*) : قائمة ثانية اختيارية من المعرّفات لأزواج التسلسلات.
**يعيد:** `list[int]`
قائمة [معرفات الإدخال](../glossary#input-ids) مع الرموز الخاصة المناسبة.
إنشاء مدخلات النموذج من تسلسل أو زوج من التسلسلات لمهام تصنيف التسلسل من خلال الربط وإضافة الرموز الخاصة. يتبع تسلسل XLM-RoBERTa التنسيق التالي:
- تسلسل واحد: ` X `
- زوج من التسلسلات: ` A B `
#### get_special_tokens_mask[[transformers.UdopTokenizer.get_special_tokens_mask]]
```python
get_special_tokens_mask(token_ids_0: list[int], token_ids_1: list[int] | None = None, already_has_special_tokens: bool = False)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/tokenization_utils_base.py#L1337)
**المعاملات:**
token_ids_0 : قائمة معرّفات (IDs) للتسلسل (الذي قد يكون منسّقًا بالفعل).
token_ids_1 : غير مستخدم عندما يكون `already_has_special_tokens=True`. يجب أن يكون None في هذه الحالة.
already_has_special_tokens : ما إذا كانت التسلسلة منسّقة مسبقًا باستخدام الرموز الخاصة.
**يعيد:** قائمة من الأعداد الصحيحة في المدى [0, 1]
1 لرمز خاص، 0 لرمز التسلسل.
استرجاع معرّفات التسلسلات من قائمة الرموز التي لم تُضف إليها أي رموز خاصة.
للمُرمِّزات السريعة، تستدعي مُجمِّعات البيانات هذه الدالة مع `already_has_special_tokens=True` لبناء قناع فوق تسلسل منسّق مسبقًا. في هذه الحالة، نحسب القناع عن طريق التحقق من العضوية في `all_special_ids`.
#### إنشاء معرّفات أنواع الرموز من التسلسلات[[transformers.UdopTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list[int], token_ids_1: list[int] | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/tokenization_udop.py#L997)
**المعاملات:**
token_ids_0 (`list[int]`) : قائمة من المعرّفات.
token_ids_1 (`list[int]`، *اختياري*) : قائمة ثانية اختيارية من المعرّفات لأزواج التسلسلات.
**يعيد:** `list[int]`
قائمة من الأصفار.
أنشئ قناعًا من التسلسلين المُمرَّرين لاستخدامه في مهمة تصنيف أزواج التسلسلات. لا يستخدم XLM-RoBERTa معرّفات أنواع الرموز، لذلك يُعاد قائمة من الأصفار.
#### save_vocabulary[[transformers.UdopTokenizer.save_vocabulary]]
```python
save_vocabulary(save_directory: str, filename_prefix: str | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/tokenization_udop.py#L1021)
احفظ ملفات مفردات المُرمِّز. بالنسبة لـ TokenizersBackend، يتم حفظ الملف tokenizer.json بواسطة الفئة الأساسية. تُعيد هذه الطريقة مجموعة فارغة (tuple) لأننا نستخدم فقط tokenizer.json.
## UdopProcessor[[transformers.UdopProcessor]]
#### transformers.UdopProcessor[[transformers.UdopProcessor]]
```python
transformers.UdopProcessor(image_processor, tokenizer)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/processing_udop.py#L50)
**المعاملات:**
image_processor (`LayoutLMv3ImageProcessor`) : مُعالج الصور هو مدخل مطلوب.
tokenizer (`UdopTokenizer`) : مُجزِّئ النص (tokenizer) هو مدخل مطلوب.
ينشئ UdopProcessor الذي يجمع معالج الصور ومجزّئ النص في معالج واحد.
يوفر [UdopProcessor](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopProcessor) جميع وظائف [LayoutLMv3ImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) و[UdopTokenizer](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopTokenizer). راجع [~LayoutLMv3ImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) و[~UdopTokenizer](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopTokenizer) لمزيد من المعلومات.
#### __call__[[transformers.UdopProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] = None, boxes: list[list[int]] | list[list[list[int]]] | None = None, word_labels: list[int] | list[list[int]] | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/processing_udop.py#L73)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *اختياري*) : الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`، *اختياري*) : التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُجزَّأ مسبقًا). إذا مررت مدخلات مُجزَّأة مسبقًا، فاضبط `is_split_into_words=True` لتجنب الغموض مع المدخلات المُجمَّعة في دفعات.
boxes (`list[list[int]]`، `list[list[list[int]]]`، *اختياري*) : صناديق حدود على مستوى الكلمات مُعايرة إلى المدى [0, 1000].
word_labels (`list[int]`، `list[list[int]]`، *اختياري*) : تسميات عددية صحيحة على مستوى الكلمة لمهام تصنيف الرموز.
return_mm_token_type_ids (`bool`, *kwargs*) : ما إذا كان يجب إرجاع معرّفات أنواع الرموز متعددة الوسائط التي تشير إلى مواضع رموز الحشو متعددة الوسائط.
return_text_replacement_offsets (`bool`، *kwargs*) : ما إذا كان يجب إرجاع إزاحات الأحرف لكل عنصر نائب متعدد الوسائط (multimodal placeholder) وعنصر الاستبدال الخاص به.
return_tensors (`str` أو [TensorType](/docs/transformers/v5.23.0/ar/internal/file_utils#transformers.TensorType)، *اختياري*) : إذا تم تعيينه، فسيُرجع تينسورات من إطار عمل محدد. القيم المقبولة هي: - `'pt'`: يُرجع كائنات `torch.Tensor` من PyTorch. - `'np'`: يُرجع كائنات `np.ndarray` من NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/ar/main_classes/processors#transformers.ProcessingKwargs)، *اختياري*) : خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
## UdopModel[[transformers.UdopModel]]
#### transformers.UdopModel[[transformers.UdopModel]]
```python
transformers.UdopModel(config: UdopConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/modeling_udop.py#L1251)
**المعاملات:**
config ([UdopConfig](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Udop الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.UdopModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, bbox: dict[str, typing.Any] | None = None, pixel_values: typing.Optional[torch.Tensor] = None, visual_bbox: dict[str, typing.Any] | None = None, decoder_input_ids: typing.Optional[torch.Tensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/modeling_udop.py#L1287)
**المعاملات:**
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
bbox (`torch.LongTensor` من الشكل `({0}, 4)`، *اختياري*) : صناديق الحدود لرموز كل تسلسل إدخال. يتم اختيارها ضمن النطاق `[0, config.max_2d_position_embeddings-1]`. يجب أن يكون كل صندوق حدود نسخة مُعايرة بصيغة (x0, y0, x1, y1)، حيث يمثل (x0, y0) موضع الزاوية العلوية اليسرى في صندوق الحدود، ويمثل (x1, y1) موضع الزاوية السفلية اليمنى. لاحظ أن `sequence_length = token_sequence_length + patch_sequence_length + 1` حيث `1` مخصص لرمز [CLS]. راجع `pixel_values` بخصوص `patch_sequence_length`.
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [LayoutLMv3ImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor). راجع [LayoutLMv3ImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([UdopProcessor](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopProcessor) يستخدم [LayoutLMv3ImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) لمعالجة الصور).
visual_bbox (`torch.LongTensor` من الشكل `(batch_size, patch_sequence_length, 4)`، *اختياري*) : صناديق الحدود لكل رقعة في الصورة. إذا لم يتم تقديمها، يتم إنشاء صناديق الحدود داخل النموذج.
decoder_input_ids (`torch.LongTensor` من الشكل `(batch_size, target_sequence_length)`، *اختياري*) : فهارس رموز تسلسل مدخلات المُفكِّك في قاموس الكلمات. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات مدخلات المُفكِّك؟](../glossary#decoder-input-ids) يستخدم T5 الرمز `pad_token_id` كرمز بداية لتوليد `decoder_input_ids`. إذا تم استخدام `past_key_values`، فيجب إدخال آخر `decoder_input_ids` فقط بشكل اختياري (انظر `past_key_values`). لمعرفة المزيد حول كيفية تحضير `decoder_input_ids` للتدريب المسبق، اطّلع على [T5 Training](./t5#training).
decoder_attention_mask (`torch.BoolTensor` من الشكل `(batch_size, target_sequence_length)`، *اختياري*) : السلوك الافتراضي: توليد متجه يتجاهل رموز الحشو في `decoder_input_ids`. سيتم استخدام القناع السببي أيضًا بشكل افتراضي.
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
encoder_outputs (`torch.Tensor`، *اختياري*) : Tuple يتكون من (`last_hidden_state`، *اختياري*: `hidden_states`، *اختياري*: `attentions`) `last_hidden_state` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) هو تسلسل من حالات الخفاء عند مخرج الطبقة الأخيرة من المُشفِّر. يُستخدم في الانتباه المتقاطع (cross-attention) في المُفكِّك.
past_key_values (`~cache_utils.Cache`، *اختياري*) : حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكوّن هذا عادةً من `past_key_values` التي يعيدها النموذج في مرحلة سابقة من فك الترميز، عندما يكون `use_cache=True` أو `config.use_cache=True`. يُسمح فقط بتمرير كائن [Cache](/docs/transformers/v5.23.0/ar/internal/generation_utils#transformers.Cache) كمدخل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache). إذا لم يتم تمرير `past_key_values`، فسيتم تهيئة [DynamicCache](/docs/transformers/v5.23.0/ar/internal/generation_utils#transformers.DynamicCache) افتراضيًا. سيُخرج النموذج نفس تنسيق الذاكرة المؤقتة المُدخل. إذا تم استخدام `past_key_values`، يُتوقع من المستخدم إدخال `input_ids` غير المعالجة فقط (تلك التي لم تُعطَ حالات مفاتيح وقيم سابقة لها في هذا النموذج) بأبعاد `(batch_size, unprocessed_length)` بدلاً من جميع `input_ids` بأبعاد `(batch_size, sequence_length)`.
decoder_inputs_embeds (`torch.Tensor` بشكل `(batch_size, target_sequence_length, hidden_size)`، *اختياري*) : اختياريًا، بدلاً من تمرير `decoder_input_ids` يمكنك اختيار تمرير تمثيل مضمّن مباشرة. إذا تم استخدام `past_key_values`، فلا يتعين إدخال سوى آخر `decoder_inputs_embeds` (انظر `past_key_values`). يكون هذا مفيدًا إذا أردت مزيدًا من التحكم في كيفية تحويل فهارس `decoder_input_ids` إلى المتجهات المرتبطة بها مقارنةً بمصفوفة البحث التضمينية الداخلية للنموذج. إذا كان كل من `decoder_input_ids` و`decoder_inputs_embeds` غير مضبوطين، فإن `decoder_inputs_embeds` يتخذ قيمة `inputs_embeds`.
use_cache (`bool`، *اختياري*) : إذا تم ضبطه على `True`، تُعاد حالات المفاتيح والقيم `past_key_values` ويمكن استخدامها لتسريع فك الترميز (انظر `past_key_values`).
**يعيد:** [Seq2SeqModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.Seq2SeqModelOutput) أو `tuple(torch.Tensor)`
[Seq2SeqModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.Seq2SeqModelOutput) أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([UdopConfig](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopConfig)) والمدخلات.
تُعيد طريقة [UdopModel](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopModel) الأمامية تعريف الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` بشكل `(batch_size, sequence_length, hidden_size)`) -- سلسلة من حالات الإخفاء عند مخرج الطبقة الأخيرة من فاحش النموذج.
إذا تم استخدام `past_key_values`، فإن الحالة المخفية الأخيرة فقط من التسلسلات ذات الشكل `(batch_size, 1, hidden_size)` هي التي تُخرج.
- **past_key_values** (`EncoderDecoderCache`، *اختياري*، يُعاد عند تمرير `use_cache=True` أو عند `config.use_cache=True`) -- هو كائن من نوع [EncoderDecoderCache](/docs/transformers/v5.23.0/ar/internal/generation_utils#transformers.EncoderDecoderCache). لمزيد من التفاصيل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache).
تحتوي على حالات مخفية محسوبة مسبقًا (مفاتيح وقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها (انظر مدخل `past_key_values`) لتسريع فك الترميز التسلسلي.
- **decoder_hidden_states** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_hidden_states=True` أو عند `config.output_hidden_states=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) من الشكل `(batch_size, sequence_length, hidden_size)`.
حالات المخفية (Hidden-states) للوحدة الترميزية (decoder) عند مخرج كل طبقة، بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **decoder_attentions** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) من الشكل `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في المفكّك، بعد softmax الانتباه، المستخدمة لحساب المتوسط المرجّح في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) من الشكل `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
- **encoder_last_hidden_state** (`torch.Tensor` بشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) -- سلسلة من حالات الإخفاء عند مخرجات الطبقة الأخيرة من المُشفِّر في النموذج.
- **encoder_hidden_states** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_hidden_states=True` أو عند `config.output_hidden_states=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) من الشكل `(batch_size, sequence_length, hidden_size)`.
حالات المخفية للمشفّر عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **encoder_attentions** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) من الشكل `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه للمُشفِّر، بعد softmax للانتباه، المُستخدَمة لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from datasets import load_dataset
>>> import torch
>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = AutoModel.from_pretrained("microsoft/udop-large")
>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> inputs = processor(image, words, boxes=boxes, return_tensors="pt")
>>> decoder_input_ids = torch.tensor([[model.config.decoder_start_token_id]])
>>> # forward pass
>>> outputs = model(**inputs, decoder_input_ids=decoder_input_ids)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 1, 1024]
```
## UdopForConditionalGeneration[[transformers.UdopForConditionalGeneration]]
#### transformers.UdopForConditionalGeneration[[transformers.UdopForConditionalGeneration]]
```python
transformers.UdopForConditionalGeneration(config: UdopConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/modeling_udop.py#L1405)
**المعاملات:**
config ([UdopConfig](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
ترميز-فك ترميز UDOP Transformer مع رأس نمذجة لغوية في الأعلى، مما يتيح توليد النص بناءً على صور المستندات وموجّه اختياري.
تستند هذه الفئة إلى [T5ForConditionalGeneration](/docs/transformers/v5.23.0/ar/model_doc/t5#transformers.T5ForConditionalGeneration)، وقد تم توسيعها للتعامل مع البيانات المتعلقة بالصور والتخطيط (ثنائي الأبعاد).
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.UdopForConditionalGeneration.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, bbox: dict[str, typing.Any] | None = None, pixel_values: typing.Optional[torch.Tensor] = None, visual_bbox: dict[str, typing.Any] | None = None, decoder_input_ids: typing.Optional[torch.Tensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/modeling_udop.py#L1447)
**المعاملات:**
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
bbox (`torch.LongTensor` من الشكل `({0}, 4)`، *اختياري*) : صناديق الحدود لرموز كل تسلسل إدخال. يتم اختيارها ضمن النطاق `[0, config.max_2d_position_embeddings-1]`. يجب أن يكون كل صندوق حدود نسخة مُعايرة بصيغة (x0, y0, x1, y1)، حيث يمثل (x0, y0) موضع الزاوية العلوية اليسرى في صندوق الحدود، ويمثل (x1, y1) موضع الزاوية السفلية اليمنى. لاحظ أن `sequence_length = token_sequence_length + patch_sequence_length + 1` حيث `1` مخصص لرمز [CLS]. راجع `pixel_values` بخصوص `patch_sequence_length`.
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [LayoutLMv3ImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor). راجع [LayoutLMv3ImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([UdopProcessor](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopProcessor) يستخدم [LayoutLMv3ImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) لمعالجة الصور).
visual_bbox (`torch.LongTensor` من الشكل `(batch_size, patch_sequence_length, 4)`، *اختياري*) : صناديق الحدود لكل رقعة في الصورة. إذا لم يتم تقديمها، يتم إنشاء صناديق الحدود داخل النموذج.
decoder_input_ids (`torch.LongTensor` من الشكل `(batch_size, target_sequence_length)`، *اختياري*) : فهارس رموز تسلسل مدخلات المُفكِّك في قاموس الكلمات. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات مدخلات المُفكِّك؟](../glossary#decoder-input-ids) يستخدم T5 الرمز `pad_token_id` كرمز بداية لتوليد `decoder_input_ids`. إذا تم استخدام `past_key_values`، فيجب إدخال آخر `decoder_input_ids` فقط بشكل اختياري (انظر `past_key_values`). لمعرفة المزيد حول كيفية تحضير `decoder_input_ids` للتدريب المسبق، اطّلع على [T5 Training](./t5#training).
decoder_attention_mask (`torch.BoolTensor` من الشكل `(batch_size, target_sequence_length)`، *اختياري*) : السلوك الافتراضي: توليد متجه يتجاهل رموز الحشو في `decoder_input_ids`. سيتم استخدام القناع السببي أيضًا بشكل افتراضي.
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
encoder_outputs (`torch.Tensor`، *اختياري*) : Tuple يتكون من (`last_hidden_state`، *اختياري*: `hidden_states`، *اختياري*: `attentions`) `last_hidden_state` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) هو تسلسل من حالات الخفاء عند مخرج الطبقة الأخيرة من المُشفِّر. يُستخدم في الانتباه المتقاطع (cross-attention) في المُفكِّك.
past_key_values (`~cache_utils.Cache`، *اختياري*) : حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها لتسريع فك الترميز التسلسلي. يتكوّن هذا عادةً من `past_key_values` التي يعيدها النموذج في مرحلة سابقة من فك الترميز، عندما يكون `use_cache=True` أو `config.use_cache=True`. يُسمح فقط بتمرير كائن [Cache](/docs/transformers/v5.23.0/ar/internal/generation_utils#transformers.Cache) كمدخل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache). إذا لم يتم تمرير `past_key_values`، فسيتم تهيئة [DynamicCache](/docs/transformers/v5.23.0/ar/internal/generation_utils#transformers.DynamicCache) افتراضيًا. سيُخرج النموذج نفس تنسيق الذاكرة المؤقتة المُدخل. إذا تم استخدام `past_key_values`، يُتوقع من المستخدم إدخال `input_ids` غير المعالجة فقط (تلك التي لم تُعطَ حالات مفاتيح وقيم سابقة لها في هذا النموذج) بأبعاد `(batch_size, unprocessed_length)` بدلاً من جميع `input_ids` بأبعاد `(batch_size, sequence_length)`.
decoder_inputs_embeds (`torch.Tensor` بشكل `(batch_size, target_sequence_length, hidden_size)`، *اختياري*) : اختياريًا، بدلاً من تمرير `decoder_input_ids` يمكنك اختيار تمرير تمثيل مضمّن مباشرة. إذا تم استخدام `past_key_values`، فلا يتعين إدخال سوى آخر `decoder_inputs_embeds` (انظر `past_key_values`). يكون هذا مفيدًا إذا أردت مزيدًا من التحكم في كيفية تحويل فهارس `decoder_input_ids` إلى المتجهات المرتبطة بها مقارنةً بمصفوفة البحث التضمينية الداخلية للنموذج. إذا كان كل من `decoder_input_ids` و`decoder_inputs_embeds` غير مضبوطين، فإن `decoder_inputs_embeds` يتخذ قيمة `inputs_embeds`.
use_cache (`bool`، *اختياري*) : إذا تم ضبطه على `True`، تُعاد حالات المفاتيح والقيم `past_key_values` ويمكن استخدامها لتسريع فك الترميز (انظر `past_key_values`).
labels (`torch.LongTensor` من الشكل `(batch_size,)`، *اختياري*) : تسميات لحساب خسارة نمذجة اللغة. يجب أن تكون الفهارس ضمن `[-100, 0, ..., config.vocab_size - 1]`. يتم تجاهل (إخفاء) جميع التسميات المضبوطة على `-100`، ولا تُحسب الخسارة إلا للتسميات ضمن `[0, ..., config.vocab_size]`.
**يعيد:** [Seq2SeqLMOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.Seq2SeqLMOutput) أو `tuple(torch.Tensor)`
[Seq2SeqLMOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.Seq2SeqLMOutput) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([UdopConfig](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopConfig)) والمدخلات.
تتجاوز طريقة [UdopForConditionalGeneration](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopForConditionalGeneration) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`، *اختياري*، يُعاد عند تقديم `labels`) -- خسارة نمذجة اللغة.
- **logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.vocab_size)`) -- درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).
- **past_key_values** (`EncoderDecoderCache`، *اختياري*، يُعاد عند تمرير `use_cache=True` أو عند `config.use_cache=True`) -- هو كائن من نوع [EncoderDecoderCache](/docs/transformers/v5.23.0/ar/internal/generation_utils#transformers.EncoderDecoderCache). لمزيد من التفاصيل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache).
تحتوي على حالات مخفية محسوبة مسبقًا (مفاتيح وقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها (انظر مدخل `past_key_values`) لتسريع فك الترميز التسلسلي.
- **decoder_hidden_states** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_hidden_states=True` أو عند `config.output_hidden_states=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) من الشكل `(batch_size, sequence_length, hidden_size)`.
حالات المخفية (Hidden states) لمفكّك الترميز (decoder) عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي (initial embedding).
- **decoder_attentions** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) من الشكل `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في المفكّك، بعد softmax الانتباه، المستخدمة لحساب المتوسط المرجّح في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) من الشكل `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
- **encoder_last_hidden_state** (`torch.Tensor` بشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) -- سلسلة من حالات الإخفاء عند مخرجات الطبقة الأخيرة من المُشفِّر في النموذج.
- **encoder_hidden_states** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_hidden_states=True` أو عند `config.output_hidden_states=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) من الشكل `(batch_size, sequence_length, hidden_size)`.
حالات المخفية للمشفّر عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي.
- **encoder_attentions** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) من الشكل `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه للمُشفِّر، بعد softmax للانتباه، المُستخدَمة لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import AutoProcessor, UdopForConditionalGeneration
>>> from datasets import load_dataset
>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = UdopForConditionalGeneration.from_pretrained("microsoft/udop-large")
>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> # one can use the various task prefixes (prompts) used during pre-training
>>> # e.g. the task prefix for DocVQA is "Question answering. "
>>> question = "Question answering. What is the date on the form?"
>>> encoding = processor(image, question, text_pair=words, boxes=boxes, return_tensors="pt")
>>> # autoregressive generation
>>> predicted_ids = model.generate(**encoding)
>>> print(processor.batch_decode(predicted_ids, skip_special_tokens=True)[0])
9/30/92
```
## UdopEncoderModel[[transformers.UdopEncoderModel]]
#### transformers.UdopEncoderModel[[transformers.UdopEncoderModel]]
```python
transformers.UdopEncoderModel(config: UdopConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/modeling_udop.py#L1579)
**المعاملات:**
config ([UdopConfig](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Udop الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.UdopEncoderModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, bbox: dict[str, typing.Any] | None = None, attention_mask: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, visual_bbox: dict[str, typing.Any] | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/udop/modeling_udop.py#L1610)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. نموذج T5 هو نموذج يتضمن تضمينات موضع نسبي، لذا يجب أن تكون قادرًا على ملء المدخلات من اليمين ومن اليسار. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. لمعرفة المزيد حول كيفية تحضير `input_ids` للتدريب المسبق، اطّلع على [T5 Training](./t5#training).
bbox (`torch.LongTensor` من الشكل `({0}, 4)`، *اختياري*) : صناديق الحدود لرموز كل تسلسل إدخال. يتم اختيارها ضمن النطاق `[0, config.max_2d_position_embeddings-1]`. يجب أن يكون كل صندوق حدود نسخة مُعايرة بصيغة (x0, y0, x1, y1)، حيث يمثل (x0, y0) موضع الزاوية العلوية اليسرى في صندوق الحدود، ويمثل (x1, y1) موضع الزاوية السفلية اليمنى. لاحظ أن `sequence_length = token_sequence_length + patch_sequence_length + 1` حيث `1` مخصص لرمز [CLS]. راجع `pixel_values` بخصوص `patch_sequence_length`.
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [LayoutLMv3ImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor). راجع [LayoutLMv3ImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([UdopProcessor](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopProcessor) يستخدم [LayoutLMv3ImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) لمعالجة الصور).
visual_bbox (`torch.LongTensor` من الشكل `(batch_size, patch_sequence_length, 4)`، *اختياري*) : صناديق الحدود لكل رقعة في الصورة. إذا لم يتم تقديمها، يتم إنشاء صناديق الحدود داخل النموذج.
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
**يعيد:** `BaseModelOutputWithAttentionMask` أو `tuple(torch.Tensor)`
`BaseModelOutputWithAttentionMask` أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([UdopConfig](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopConfig)) والمدخلات.
تتجاوز طريقة [UdopEncoderModel](/docs/transformers/v5.23.0/ar/model_doc/udop#transformers.UdopEncoderModel) الخاصة بـ forward الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء عند مخرجات الطبقة الأخيرة من النموذج. إذا تم استخدام `past_key_values`، فسيتم إخراج حالة الإخفاء الأخيرة فقط للتسلسلات من الشكل `(batch_size, 1, hidden_size)`.
- **attention_mask** (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) -- قناع الانتباه المستخدم في المسار الأمامي للنموذج لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`:
- 1 للرموز التي **لم تُقنَّع**،
- 0 للرموز التي تم **إخفاؤها**.
- **past_key_values** (`Cache`، *اختياري*، يُعاد عند تمرير `use_cache=True` أو عند تعيين `config.use_cache=True`) -- هو كائن من نوع [Cache](/docs/transformers/v5.23.0/ar/internal/generation_utils#transformers.Cache). لمزيد من التفاصيل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache).
تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي، وفي كتل الانتباه المتقاطع اختياريًا إذا كان `config.is_encoder_decoder=True`) يمكن استخدامها (انظر مدخل `past_key_values`) لتسريع فك الترميز التسلسلي.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`. حالات مخفية للنموذج عند إخراج كل طبقة بالإضافة إلى إخراجات التضمين الأولية الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`. أوزان الانتباه بعد تطبيق softmax على الانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` و`config.add_cross_attention=True` أو عند `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`. أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد دالة softmax للانتباه، وتُستخدم لحساب المتوسط المرجح في رؤوس الانتباه المتقاطع.
مثال:
```python
>>> from transformers import AutoProcessor, UdopEncoderModel
>>> from huggingface_hub import hf_hub_download
>>> from datasets import load_dataset
>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = UdopEncoderModel.from_pretrained("microsoft/udop-large")
>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> encoding = processor(image, words, boxes=boxes, return_tensors="pt")
>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state
```