# LLaVa
## Ikhtisar
LLaVa adalah chatbot open-source yang dilatih dengan fine-tuning LlamA/Vicuna pada data multimodal mengikuti instruksi yang dihasilkan GPT. Ini adalah model bahasa auto-regresif, berdasarkan arsitektur transformer. Dengan kata lain, ini adalah versi multi-modal dari LLM yang di-fine-tune untuk chat / instruksi.
Model LLaVa diusulkan dalam [Visual Instruction Tuning](https://huggingface.co/papers/2304.08485) dan ditingkatkan dalam [Improved Baselines with Visual Instruction Tuning](https://huggingface.co/papers/2310.03744) oleh Haotian Liu, Chunyuan Li, Yuheng Li, dan Yong Jae Lee.
Abstrak dari makalah tersebut adalah sebagai berikut:
*Model multimodal besar (LMM) baru-baru ini menunjukkan kemajuan yang menjanjikan dengan penyetelan instruksi visual. Dalam catatan ini, kami menunjukkan bahwa konektor lintas-modal bahasa-visi yang sepenuhnya terhubung (fully-connected) dalam LLaVA ternyata sangat kuat dan efisien dalam penggunaan data. Dengan modifikasi sederhana pada LLaVA, yaitu menggunakan CLIP-ViT-L-336px dengan proyeksi MLP dan menambahkan data VQA yang berorientasi pada tugas akademik dengan prompt format respons sederhana, kami menetapkan baseline yang lebih kuat yang mencapai state-of-the-art di 11 benchmark. Checkpoint 13B akhir kami hanya menggunakan 1,2 juta data yang tersedia secara publik, dan menyelesaikan pelatihan penuh dalam ∼1 hari pada satu node 8-A100. Kami berharap ini dapat membuat penelitian LMM state-of-the-art menjadi lebih mudah diakses. Kode dan model akan tersedia secara publik*
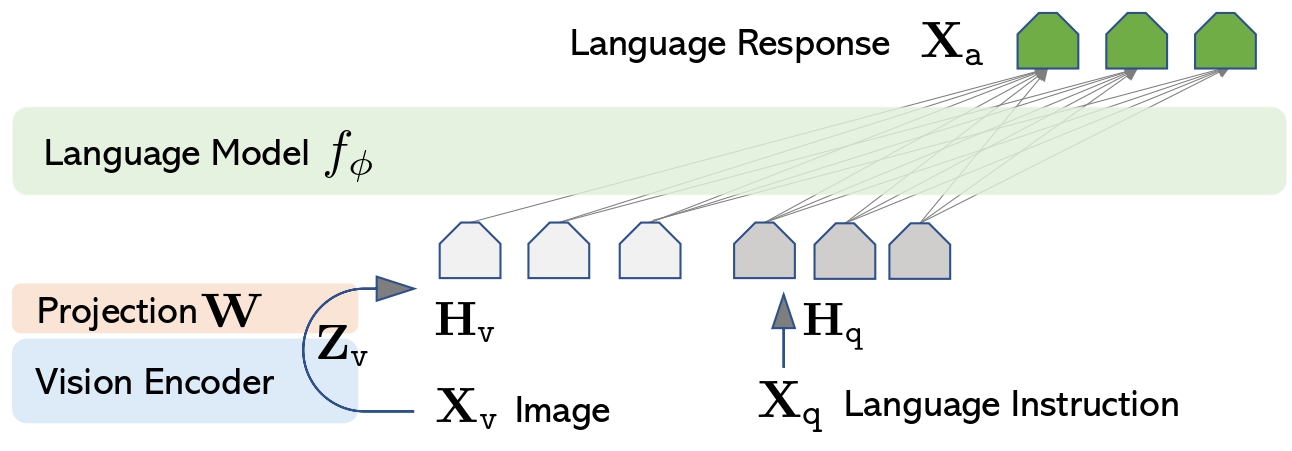 Arsitektur LLaVa. Diambil dari paper aslinya.
Model ini disumbangkan oleh [ArthurZ](https://huggingface.co/ArthurZ) dan [ybelkada](https://huggingface.co/ybelkada). Kode aslinya dapat ditemukan [di sini](https://github.com/haotian-liu/LLaVA/tree/main/llava).
> [!TIP]
> Setel `use_kernels=True` di [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk mengganti lapisan yang didukung dengan kernel yang dioptimalkan dari Hub. Lihat [Memuat kernel](../kernel_doc/loading_kernels) untuk mempelajari lebih lanjut.
## Tips penggunaan
- Kami menyarankan pengguna untuk menggunakan `padding_side="left"` saat menghitung generasi batched karena menghasilkan akurasi yang lebih baik. Cukup pastikan untuk memanggil `processor.tokenizer.padding_side = "left"` sebelum melakukan generasi.
- Perhatikan bahwa model tidak dilatih secara eksplisit untuk memproses beberapa gambar dalam prompt yang sama, meskipun secara teknis memungkinkan, Anda mungkin mengalami hasil yang tidak akurat.
> [!NOTE]
> Model LLaVA setelah rilis v4.46 akan menampilkan peringatan tentang penambahan `processor.patch_size = {{patch_size}}`, `processor.num_additional_image_tokens = {{num_additional_image_tokens}}`, dan `processor.vision_feature_select_strategy = {{vision_feature_select_strategy}}`. Sangat disarankan untuk menambahkan atribut tersebut ke processor jika Anda memiliki checkpoint modelnya, atau membuka PR jika checkpoint tersebut bukan milik Anda.
Menambahkan atribut-atribut ini berarti LLaVA akan mencoba memperkirakan jumlah token gambar yang diperlukan per gambar dan memperluas teks dengan sebanyak mungkin placeholder `` sebanyak jumlah token tersebut. Biasanya sekitar 500 token per gambar, jadi pastikan teks tidak terpotong karena jika tidak, akan terjadi kegagalan saat menggabungkan embedding. Atribut-atribut ini dapat diperoleh dari konfigurasi model, seperti `model.config.vision_config.patch_size` atau `model.config.vision_feature_select_strategy`. Nilai `num_additional_image_tokens` harus `1` jika vision backbone menambahkan token CLS atau `0` jika tidak ada tambahan apa pun pada vision patches.
### Memformat Prompt dengan Template Chat
Setiap **checkpoint** dilatih dengan format prompt tertentu, tergantung pada backbone model bahasa besar yang mendasarinya. Untuk memastikan format yang benar, gunakan metode `apply_chat_template` dari processor.
**Penting:**
- Anda harus membuat riwayat percakapan — meneruskan string polos tidak akan berhasil.
- Setiap pesan harus berupa kamus dengan kunci `"role"` dan `"content"`.
- `"content"` harus berupa daftar kamus untuk berbagai modalitas seperti `"text"` dan `"image"`.
Berikut adalah contoh cara menyusun input Anda. Kami akan menggunakan [llava-hf/llava-1.5-7b-hf](https://huggingface.co/llava-hf/llava-1.5-7b-hf) dan riwayat percakapan berupa teks dan gambar. Setiap field konten harus berupa daftar dict, sebagai berikut:
```python
from transformers import AutoProcessor
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
conversation = [
{
"role": "user",
"content": [
{"type": "image"},
{"type": "text", "text": "What’s shown in this image?"},
],
},
{
"role": "assistant",
"content": [{"type": "text", "text": "This image shows a red stop sign."},]
},
{
"role": "user",
"content": [
{"type": "text", "text": "Describe the image in more details."},
],
},
]
text_prompt = processor.apply_chat_template(conversation, add_generation_prompt=True)
# Note that the template simply formats your prompt, you still have to tokenize it and obtain pixel values for your images
print(text_prompt)
"USER: \nUSER: Describe the image in more details. ASSISTANT:"
```
- Jika Anda ingin membuat prompt chat sendiri, di bawah ini adalah daftar format prompt yang diterima oleh setiap checkpoint llava:
Model [llava-interleave](https://huggingface.co/collections/llava-hf/llava-interleave-668e19a97da0036aad4a2f19) memerlukan format berikut:
```bash
"<|im_start|>user \nWhat is shown in this image?<|im_end|><|im_start|>assistant"
```
Untuk percakapan multi-pusingan:
```bash
"<|im_start|>user \n<|im_end|><|im_start|>assistant <|im_end|><|im_start|>user \n<|im_end|><|im_start|>assistant "
```
Model [llava-1.5](https://huggingface.co/collections/llava-hf/llava-15-65f762d5b6941db5c2ba07e0) memerlukan format berikut:
```bash
"USER: \n ASSISTANT:"
```
Untuk percakapan multi-pusingan:
```bash
"USER: \n ASSISTANT: USER: ASSISTANT: USER: ASSISTANT:"
```
🚀 **Bonus:** Jika Anda menggunakan `transformers>=4.49.0`, Anda juga dapat memperoleh output vektor dari `apply_chat_template`. Lihat **Contoh Penggunaan** di bawah untuk detail lebih lanjut tentang cara menggunakannya.
## Contoh penggunaan
### Inferensi input tunggal
```python
import torch
from transformers import AutoProcessor, LlavaForConditionalGeneration
# Load the model in half-precision
model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf", device_map="auto")
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
conversation = [
{
"role": "user",
"content": [
{"type": "image", "url": "https://www.ilankelman.org/stopsigns/australia.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
inputs = processor.apply_chat_template(
conversation,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt"
).to(model.device, torch.float16)
# Generate
generate_ids = model.generate(**inputs, max_new_tokens=30)
processor.batch_decode(generate_ids, skip_special_tokens=True)
```
### Inferensi berbatch
LLaVa juga mendukung inferensi batched. Berikut cara melakukannya:
```python
import torch
from transformers import AutoProcessor, LlavaForConditionalGeneration
# Load the model in half-precision
model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf", device_map="auto")
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
# Prepare a batch of two prompts
conversation_1 = [
{
"role": "user",
"content": [
{"type": "image", "url": "https://www.ilankelman.org/stopsigns/australia.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
conversation_2 = [
{
"role": "user",
"content": [
{"type": "image", "url": "http://images.cocodataset.org/val2017/000000039769.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
inputs = processor.apply_chat_template(
[conversation_1, conversation_2],
add_generation_prompt=True,
tokenize=True,
return_dict=True,
padding=True,
return_tensors="pt"
).to(model.device, torch.float16)
# Generate
generate_ids = model.generate(**inputs, max_new_tokens=30)
processor.batch_decode(generate_ids, skip_special_tokens=True)
```
## Catatan mengenai reproduksi implementasi asli
Untuk mencocokkan logits dari [implementasi asli](https://github.com/haotian-liu/LLaVA/tree/main), Anda perlu secara tambahan menentukan `do_pad=True` saat menginstansiasi `LlavaImageProcessor`:
```python
from transformers import LlavaImageProcessor
image_processor = LlavaImageProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf", do_pad=True)
```
### Menggunakan Flash Attention 2
Flash Attention 2 adalah versi yang lebih cepat dan dioptimalkan dari optimasi sebelumnya, silakan lihat [bagian Flash Attention 2 di dokumen kinerja](https://huggingface.co/docs/transformers/perf_infer_gpu_one).
## Sumber daya
Daftar sumber resmi Hugging Face dan komunitas (ditandai dengan 🌎) untuk membantu Anda memulai dengan LLaVa.
- Demo [Google Colab](https://colab.research.google.com/drive/1qsl6cd2c8gGtEW1xV5io7S8NHh-Cp1TV?usp=sharing) tentang cara menjalankan Llava pada instance Google Colab gratis dengan memanfaatkan inferensi 4-bit.
- [Notebook serupa](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/LLaVa/Inference_with_LLaVa_for_multimodal_generation.ipynb) yang menampilkan inferensi batch. 🌎
## LlavaConfig[[transformers.LlavaConfig]]
#### transformers.LlavaConfig[[transformers.LlavaConfig]]
```python
transformers.LlavaConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, image_token_index: int = 32000, image_seq_length: int = 576, projector_hidden_act: str = 'gelu', vision_feature_select_strategy: typing.Literal['default', 'full'] = 'default', vision_feature_layer: int | list[int] = -2, multimodal_projector_bias: bool = True, tie_word_embeddings: bool = False)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/configuration_llava.py#L26)
**Parameter:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opsional*) : Objek config atau dictionary dari vision backbone.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opsional*) : Objek config atau dictionary dari text backbone.
image_token_index (`int`, *opsional*, defaultnya `32000`) : Indeks token gambar yang digunakan sebagai placeholder untuk gambar input.
image_seq_length (`int`, *opsional*, defaultnya `576`) : Panjang sekuens dari satu embedding gambar.
projector_hidden_act (`str`, *opsional*, defaultnya `gelu`) : Fungsi aktivasi yang digunakan oleh proyektor multimodal.
vision_feature_select_strategy (`Literal[default, full]`, *opsional*, defaultnya `default`) : Strategi pemilihan fitur yang digunakan untuk memilih fitur visual dari tulang punggung visual.
vision_feature_layer (`Union[int, list[int]]`, *opsional*, defaultnya `-2`) : Indeks dari lapisan untuk memilih fitur visual. Jika beberapa indeks diberikan, fitur visual dari indeks yang sesuai akan digabungkan untuk membentuk fitur visual.
multimodal_projector_bias (`bool`, *opsional*, defaultnya `True`) : Apakah akan menggunakan bias pada proyektor multimodal.
tie_word_embeddings (`bool`, *opsional*, defaultnya `False`) : Apakah mengikat embedding bobot sesuai dengan pemetaan `tied_weights_keys` model.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari LlavaModel. Kelas ini digunakan untuk membuat instans model Llava sesuai dengan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [llava-hf/llava-1.5-7b-hf](https://huggingface.co/llava-hf/llava-1.5-7b-hf)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import LlavaForConditionalGeneration, LlavaConfig, CLIPVisionConfig, LlamaConfig
>>> # Initializing a CLIP-vision config
>>> vision_config = CLIPVisionConfig()
>>> # Initializing a Llama config
>>> text_config = LlamaConfig()
>>> # Initializing a Llava llava-1.5-7b style configuration
>>> configuration = LlavaConfig(vision_config, text_config)
>>> # Initializing a model from the llava-1.5-7b style configuration
>>> model = LlavaForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## LlavaImageProcessor[[transformers.LlavaImageProcessor]]
#### transformers.LlavaImageProcessor[[transformers.LlavaImageProcessor]]
```python
transformers.LlavaImageProcessor(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/image_processing_llava.py#L38)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'shortest_edge' : 224}`): Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 224, 'width': 224}`): Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `3`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.48145466, 0.4578275, 0.40821073]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.26862954, 0.26130258, 0.27577711]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah akan melakukan padding pada gambar. Padding dilakukan ke ukuran terbesar dalam batch atau ke ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
Membangun pemroses gambar LlavaImageProcessor.
#### preprocess[[transformers.LlavaImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Gambar yang akan dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opsional*) : Flag pengembang untuk input tambahan yang mirip gambar yang juga akan dipreprocess. Gunakan ini hanya jika meneruskan input sebagai kwarg tidak berhasil. Misalnya, `preprocess(images, masks=masks)` adalah pilihan yang disarankan, tetapi dapat menyebabkan masalah prioritas argumen pada beberapa model. Dalam kasus tersebut, `preprocess(images, image_like_inputs={"masks": masks})` dapat digunakan sebagai gantinya.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
Praproses sebuah gambar atau kumpulan gambar.
## LlavaImageProcessorPil[[transformers.LlavaImageProcessorPil]]
#### transformers.LlavaImageProcessorPil[[transformers.LlavaImageProcessorPil]]
```python
transformers.LlavaImageProcessorPil(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/image_processing_pil_llava.py#L31)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'shortest_edge' : 224}`): Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 224, 'width': 224}`): Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `3`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.48145466, 0.4578275, 0.40821073]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.26862954, 0.26130258, 0.27577711]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah akan melakukan padding pada gambar. Padding dilakukan ke ukuran terbesar dalam batch atau ke ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
Membangun pemroses gambar LlavaImageProcessor.
#### preprocess[[transformers.LlavaImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Gambar yang akan dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opsional*) : Flag pengembang untuk input tambahan yang mirip gambar yang juga akan dipreprocess. Gunakan ini hanya jika meneruskan input sebagai kwarg tidak berhasil. Misalnya, `preprocess(images, masks=masks)` adalah pilihan yang disarankan, tetapi dapat menyebabkan masalah prioritas argumen pada beberapa model. Dalam kasus tersebut, `preprocess(images, image_like_inputs={"masks": masks})` dapat digunakan sebagai gantinya.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
Praproses sebuah gambar atau kumpulan gambar.
## LlavaProcessor[[transformers.LlavaProcessor]]
#### transformers.LlavaProcessor[[transformers.LlavaProcessor]]
```python
transformers.LlavaProcessor(image_processor = None, tokenizer = None, patch_size = None, vision_feature_select_strategy = None, chat_template = None, image_token = '', num_additional_image_tokens = 0, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/processing_llava.py#L37)
**Parameter:**
image_processor (`LlavaImageProcessor`) : Prosesor gambar adalah input yang wajib.
tokenizer (`TokenizersBackend`) : Tokenizer adalah input yang wajib.
patch_size (`int`, *opsional*) : Ukuran patch dari menara visual.
vision_feature_select_strategy (`str`, *opsional*) : Strategi pemilihan fitur yang digunakan untuk memilih fitur visual dari tulang punggung visual. Harus sama dengan yang ada di konfigurasi model
chat_template (`str`) : Template Jinja untuk mengonversi daftar pesan dalam chat menjadi string yang dapat ditokenisasi.
image_token (`str`, *opsional*, defaultnya `""`) : Token khusus yang digunakan untuk menunjukkan lokasi gambar.
num_additional_image_tokens (`int`, *opsional*, default 0) : Jumlah token tambahan yang ditambahkan ke embedding gambar, seperti CLS (+1). Jika backbone tidak memiliki CLS atau token tambahan lainnya yang ditambahkan, tidak perlu mengatur argumen ini.
Membangun LlavaProcessor yang membungkus image processor dan tokenizer menjadi satu processor.
[LlavaProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaProcessor) menyediakan semua fungsionalitas dari [LlavaImageProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaImageProcessor) dan [TokenizersBackend](/docs/transformers/main/id/main_classes/tokenizer#transformers.TokenizersBackend). Lihat [~LlavaImageProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaImageProcessor) dan [~TokenizersBackend](/docs/transformers/main/id/main_classes/tokenizer#transformers.TokenizersBackend) untuk informasi lebih lanjut.
#### __call__[[transformers.LlavaProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L659)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opsional*) : Gambar untuk dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opsional*) : Urutan atau batch dari urutan yang akan dienkod. Setiap urutan dapat berupa string atau daftar string (string yang sudah dipretokenisasi). Jika Anda memasukkan input yang sudah dipretokenisasi, setel `is_split_into_words=True` untuk menghindari ambiguitas dengan input yang di-batch.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *opsional*) : Video yang akan dipreprocess. Mengharapkan satu video atau batch video dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan video dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *opsional*) : Audio atau batch audio yang akan disiapkan. Setiap audio dapat berupa array NumPy atau tensor PyTorch. Jika berupa array NumPy/tensor PyTorch, setiap audio harus memiliki bentuk (C, T), di mana C adalah jumlah channel, dan T adalah panjang sampel audio.
return_tensors (`str` atau [TensorType](/docs/transformers/main/id/internal/file_utils#transformers.TensorType), *opsional*) : Jika diatur, akan mengembalikan tensor dari framework tertentu. Nilai yang dapat diterima adalah: - `'pt'`: Mengembalikan objek `torch.Tensor` PyTorch. - `'np'`: Mengembalikan objek `np.ndarray` NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/id/main_classes/processors#transformers.ProcessingKwargs), *opsional*) : Opsi pemrosesan tambahan untuk setiap modalitas (teks, gambar, video, audio). Parameter spesifik model tercantum di atas; lihat kelas TypedDict untuk daftar lengkap argumen yang didukung.
## LlavaModel[[transformers.LlavaModel]]
#### transformers.LlavaModel[[transformers.LlavaModel]]
```python
transformers.LlavaModel(config: LlavaConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L130)
**Parameter:**
config ([LlavaConfig](/docs/transformers/main/id/model_doc/llava#transformers.LlavaConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model Llava yang terdiri dari tulang punggung visual dan model bahasa, tanpa kepala pemodelan bahasa.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.LlavaModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, image_sizes: typing.Optional[torch.Tensor] = None, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L217)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [LlavaImageProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaImageProcessor). Lihat [LlavaImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([LlavaProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaProcessor) menggunakan [LlavaImageProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaImageProcessor) untuk memproses gambar).
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
position_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks posisi token dari setiap urutan input dalam embedding posisi. Dipilih dalam rentang `[0, config.n_positions - 1]`. [Apa itu position ID?](../glossary#position-ids)
past_key_values (`~cache_utils.Cache`, *opsional*) : Hidden-states yang telah dihitung sebelumnya (key dan values di blok self-attention dan di blok cross-attention) yang dapat digunakan untuk mempercepat decoding berurutan. Ini biasanya terdiri dari `past_key_values` yang dikembalikan oleh model pada tahap decoding sebelumnya, ketika `use_cache=True` atau `config.use_cache=True`. Hanya instance [Cache](/docs/transformers/main/id/internal/generation_utils#transformers.Cache) yang diizinkan sebagai input, lihat [panduan kv cache](https://huggingface.co/docs/transformers/en/kv_cache) kami. Jika tidak ada `past_key_values` yang diteruskan, [DynamicCache](/docs/transformers/main/id/internal/generation_utils#transformers.DynamicCache) akan diinisialisasi secara default. Model akan mengoutput format cache yang sama dengan yang diberikan sebagai input. Jika `past_key_values` digunakan, pengguna diharapkan untuk hanya menginput `input_ids` yang belum diproses (yang tidak memiliki state past key value mereka diberikan ke model ini) dengan bentuk `(batch_size, unprocessed_length)` alih-alih semua `input_ids` dengan bentuk `(batch_size, sequence_length)`.
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model.
vision_feature_layer (`Union[int, list[int]]`, *opsional*) : Indeks dari lapisan untuk memilih fitur visual. Jika beberapa indeks diberikan, fitur visual dari indeks yang sesuai akan digabungkan untuk membentuk fitur visual.
vision_feature_select_strategy (`str`, *opsional*) : Strategi pemilihan fitur yang digunakan untuk memilih fitur visual dari tulang punggung visual. Dapat berupa salah satu dari `"default"` atau `"full"`.
image_sizes (`torch.Tensor` dengan bentuk `(batch_size, 2)`, *opsional*) : Ukuran gambar dalam batch, berupa (tinggi, lebar) untuk setiap gambar.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *opsional*) : Dict di mana kuncinya adalah modalitas yang didukung dan nilainya adalah output terenkod untuk modalitas tersebut. Setiap output terenkod adalah tuple yang terdiri dari (`pooler_output`, *opsional*: `last_hidden_states`, *opsional*: `hidden_states`, *opsional*: `attentions`) `pooler_output` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) adalah rangkaian fitur multimodal dari encoder yang digabungkan ke dalam embedding teks.
**Mengembalikan:** `LlavaModelOutputWithPast` atau `tuple(torch.Tensor)`
`LlavaModelOutputWithPast` atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([LlavaConfig](/docs/transformers/main/id/model_doc/llava#transformers.LlavaConfig)) dan input.
Metode forward dari [LlavaModel](/docs/transformers/main/id/model_doc/llava#transformers.LlavaModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
Jika `past_key_values` digunakan, hanya hidden-state terakhir dari sekuens dengan bentuk `(batch_size, 1, hidden_size)` yang dioutput.
- **past_key_values** (`Cache`, *opsional*, dikembalikan saat `use_cache=True` dilewatkan atau saat `config.use_cache=True`) -- Ini adalah instance [Cache](/docs/transformers/main/id/internal/generation_utils#transformers.Cache). Untuk detail lebih lanjut, lihat [panduan kv cache](https://huggingface.co/docs/transformers/en/kv_cache) kami.
Berisi hidden-states yang telah dihitung sebelumnya (key dan values di blok self-attention) yang dapat digunakan (lihat input `past_key_values`) untuk mempercepat decoding berurutan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
- **image_hidden_states** (`torch.Tensor`, *opsional*) -- Sebuah `torch.Tensor` berukuran `(batch_size, num_images, sequence_length, hidden_size)`. image_hidden_states dari model yang dihasilkan oleh vision encoder dan setelah memproyeksikan hidden state terakhir.
#### get_image_features[[transformers.LlavaModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, image_sizes: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L139)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [LlavaImageProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaImageProcessor). Lihat [LlavaImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([LlavaProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaProcessor) menggunakan [LlavaImageProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaImageProcessor) untuk memproses gambar).
vision_feature_layer (`Union[int, list[int]]`, *opsional*) : Indeks dari lapisan untuk memilih fitur visual. Jika beberapa indeks diberikan, fitur visual dari indeks yang sesuai akan digabungkan untuk membentuk fitur visual.
vision_feature_select_strategy (`str`, *opsional*) : Strategi pemilihan fitur yang digunakan untuk memilih fitur visual dari tulang punggung visual. Dapat berupa salah satu dari `"default"` atau `"full"`.
image_sizes (`torch.Tensor` dengan bentuk `(batch_size, 2)`, *opsional*) : Ukuran gambar dalam batch, berupa (tinggi, lebar) untuk setiap gambar.
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
Sebuah [BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([LlavaConfig](/docs/transformers/main/id/model_doc/llava#transformers.LlavaConfig)) dan input.
Mengambil state tersembunyi terakhir dari gambar dari menara visual dan menerapkan proyeksi multimodal.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
#### get_placeholder_mask[[transformers.LlavaModel.get_placeholder_mask]]
```python
get_placeholder_mask(input_ids: LongTensor, inputs_embeds: Tensor, image_features: Tensor)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L193)
Mengambil mask placeholder multimodal dari `input_ids` atau `inputs_embeds`, dan memeriksa bahwa jumlah token placeholder sama dengan panjang fitur multimodal. Jika panjangnya berbeda, error akan dilempar.
## LlavaForConditionalGeneration[[transformers.LlavaForConditionalGeneration]]
#### transformers.LlavaForConditionalGeneration[[transformers.LlavaForConditionalGeneration]]
```python
transformers.LlavaForConditionalGeneration(config: LlavaConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L282)
**Parameter:**
config ([LlavaConfig](/docs/transformers/main/id/model_doc/llava#transformers.LlavaConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model LLAVA yang terdiri dari tulang punggung visual dan model bahasa.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.LlavaForConditionalGeneration.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, labels: typing.Optional[torch.LongTensor] = None, logits_to_keep: typing.Union[int, torch.Tensor] = 0, image_sizes: typing.Optional[torch.Tensor] = None, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L310)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [LlavaImageProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaImageProcessor). Lihat [LlavaImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([LlavaProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaProcessor) menggunakan [LlavaImageProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaImageProcessor) untuk memproses gambar).
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
position_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks posisi token dari setiap urutan input dalam embedding posisi. Dipilih dalam rentang `[0, config.n_positions - 1]`. [Apa itu position ID?](../glossary#position-ids)
past_key_values (`~cache_utils.Cache`, *opsional*) : Hidden-states yang telah dihitung sebelumnya (key dan values di blok self-attention dan di blok cross-attention) yang dapat digunakan untuk mempercepat decoding berurutan. Ini biasanya terdiri dari `past_key_values` yang dikembalikan oleh model pada tahap decoding sebelumnya, ketika `use_cache=True` atau `config.use_cache=True`. Hanya instance [Cache](/docs/transformers/main/id/internal/generation_utils#transformers.Cache) yang diizinkan sebagai input, lihat [panduan kv cache](https://huggingface.co/docs/transformers/en/kv_cache) kami. Jika tidak ada `past_key_values` yang diteruskan, [DynamicCache](/docs/transformers/main/id/internal/generation_utils#transformers.DynamicCache) akan diinisialisasi secara default. Model akan mengoutput format cache yang sama dengan yang diberikan sebagai input. Jika `past_key_values` digunakan, pengguna diharapkan untuk hanya menginput `input_ids` yang belum diproses (yang tidak memiliki state past key value mereka diberikan ke model ini) dengan bentuk `(batch_size, unprocessed_length)` alih-alih semua `input_ids` dengan bentuk `(batch_size, sequence_length)`.
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model.
vision_feature_layer (`Union[int, list[int]]`, *opsional*) : Indeks dari lapisan untuk memilih fitur visual. Jika beberapa indeks diberikan, fitur visual dari indeks yang sesuai akan digabungkan untuk membentuk fitur visual.
vision_feature_select_strategy (`str`, *opsional*) : Strategi pemilihan fitur yang digunakan untuk memilih fitur visual dari tulang punggung visual. Dapat berupa salah satu dari `"default"` atau `"full"`.
labels (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Label untuk menghitung kerugian pemodelan bahasa yang disamarkan. Indeks harus berada di `[0, ..., config.vocab_size]` atau -100 (lihat docstring `input_ids`). Token dengan indeks yang disetel ke `-100` diabaikan (disamarkan), kerugian hanya dihitung untuk token dengan label di `[0, ..., config.vocab_size]`.
logits_to_keep (`Union[int, torch.Tensor]`, *opsional*, defaultnya `0`) : Jika berupa `int`, hitung logits untuk `logits_to_keep` token terakhir. Jika `0`, hitung logits untuk semua `input_ids` (kasus khusus). Hanya logits token terakhir yang diperlukan untuk generasi, dan menghitungnya hanya untuk token tersebut dapat menghemat memori, yang menjadi cukup signifikan untuk urutan panjang atau ukuran kosakata besar. Jika berupa `torch.Tensor`, harus 1D yang sesuai dengan indeks yang akan dipertahankan pada dimensi panjang urutan. Ini berguna saat menggunakan format tensor terpadu (satu dimensi untuk batch dan panjang urutan).
image_sizes (`torch.Tensor` dengan bentuk `(batch_size, 2)`, *opsional*) : Ukuran gambar dalam batch, berupa (tinggi, lebar) untuk setiap gambar.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *opsional*) : Dict di mana kuncinya adalah modalitas yang didukung dan nilainya adalah output terenkod untuk modalitas tersebut. Setiap output terenkod adalah tuple yang terdiri dari (`pooler_output`, *opsional*: `last_hidden_states`, *opsional*: `hidden_states`, *opsional*: `attentions`) `pooler_output` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) adalah rangkaian fitur multimodal dari encoder yang digabungkan ke dalam embedding teks.
**Mengembalikan:** `LlavaCausalLMOutputWithPast` atau `tuple(torch.Tensor)`
A `LlavaCausalLMOutputWithPast` atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([LlavaConfig](/docs/transformers/main/id/model_doc/llava#transformers.LlavaConfig)) dan input.
Metode forward dari [LlavaForConditionalGeneration](/docs/transformers/main/id/model_doc/llava#transformers.LlavaForConditionalGeneration) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan saat `labels` disediakan) -- Loss pemodelan bahasa (untuk prediksi token berikutnya).
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, config.vocab_size)`) -- Skor prediksi dari kepala pemodelan bahasa (skor untuk setiap token kosakata sebelum SoftMax).
- **past_key_values** (`Cache`, *opsional*, dikembalikan saat `use_cache=True` dilewatkan atau saat `config.use_cache=True`) -- Ini adalah instance [Cache](/docs/transformers/main/id/internal/generation_utils#transformers.Cache). Untuk detail lebih lanjut, lihat [panduan kv cache](https://huggingface.co/docs/transformers/en/kv_cache) kami.
Berisi hidden-states yang telah dihitung sebelumnya (key dan values di blok self-attention) yang dapat digunakan (lihat input `past_key_values`) untuk mempercepat decoding berurutan.
- **hidden_states** (`tuple[torch.Tensor]`, *opsional*, dikembalikan ketika `output_hidden_states=True` dilewatkan atau ketika `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple[torch.Tensor]`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
- **image_hidden_states** (`torch.Tensor`, *opsional*) -- Sebuah `torch.Tensor` berukuran `(batch_size, num_images, sequence_length, hidden_size)`. image_hidden_states dari model yang dihasilkan oleh vision encoder dan setelah memproyeksikan hidden state terakhir.
Contoh:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, LlavaForConditionalGeneration
>>> model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> prompt = "USER: \nWhat's the content of the image? ASSISTANT:"
>>> url = "https://www.ilankelman.org/stopsigns/australia.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, text=prompt, return_tensors="pt")
>>> # Generate
>>> generate_ids = model.generate(**inputs, max_new_tokens=15)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"USER: \nWhat's the content of the image? ASSISTANT: The image features a busy city street with a stop sign prominently displayed"
```
#### get_image_features[[transformers.LlavaForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/llava/modeling_llava.py#L295)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [LlavaImageProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaImageProcessor). Lihat [LlavaImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([LlavaProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaProcessor) menggunakan [LlavaImageProcessor](/docs/transformers/main/id/model_doc/llava#transformers.LlavaImageProcessor) untuk memproses gambar).
vision_feature_layer (`Union[int, list[int]]`, *opsional*) : Indeks dari lapisan untuk memilih fitur visual. Jika beberapa indeks diberikan, fitur visual dari indeks yang sesuai akan digabungkan untuk membentuk fitur visual.
vision_feature_select_strategy (`str`, *opsional*) : Strategi pemilihan fitur yang digunakan untuk memilih fitur visual dari tulang punggung visual. Dapat berupa salah satu dari `"default"` atau `"full"`.
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
Sebuah [BaseModelOutputWithPooling](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([LlavaConfig](/docs/transformers/main/id/model_doc/llava#transformers.LlavaConfig)) dan input.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, LlavaForConditionalGeneration
>>> model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```