# Deformable DETR
[Deformable DETR](https://huggingface.co/papers/2010.04159), deformable dikkat modülü kullanarak orijinal [DETR](./detr)'in üzerine geliştirme yapar. Bu mekanizma, bir referansın etrafındaki küçük bir anahtar örneklem noktası kümesine seçici olarak dikkat eder. Eğitim hızını ve doğruluğu artırır.
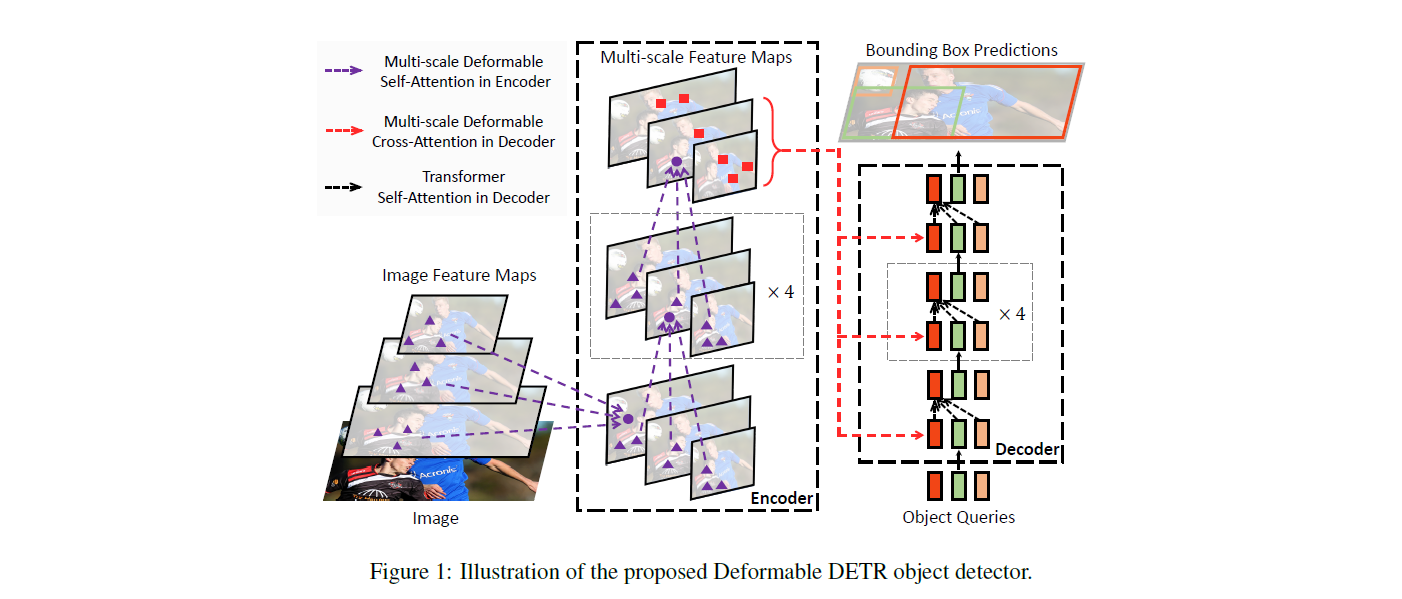 Deformable DETR mimarisi. Orijinal makaleden alınmıştır.
Kullanılabilir tüm Deformable DETR checkpoint'lerini [SenseTime](https://huggingface.co/SenseTime) kuruluşu altında bulabilirsiniz.
> [!TIP]
> Bu model [nielsr](https://huggingface.co/nielsr) tarafından katkıda bulunmuştur.
>
> Deformable DETR'nin farklı nesne algılama ve segmentasyon görevlerine nasıl uygulanacağına dair daha fazla örnek için sağ kenar çubuğundaki Deformable DETR modellerine tıklayın.
Aşağıdaki örnek, [Pipeline](/docs/transformers/main/tr/main_classes/pipelines#transformers.Pipeline) ve [AutoModel](/docs/transformers/main/tr/model_doc/auto#transformers.AutoModel) sınıfı ile nesne algılama işleminin nasıl gerçekleştirileceğini göstermektedir.
```python
from transformers import pipeline
pipeline = pipeline(
"object-detection",
model="SenseTime/deformable-detr",
device_map=0
)
pipeline("http://images.cocodataset.org/val2017/000000039769.jpg")
```
```python
import requests
import torch
from PIL import Image
from transformers import AutoImageProcessor, AutoModelForObjectDetection
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
model = AutoModelForObjectDetection.from_pretrained("SenseTime/deformable-detr", device_map="auto")
# prepare image for the model
inputs = image_processor(images=image, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
results = image_processor.post_process_object_detection(outputs, target_sizes=torch.tensor([image.size[::-1]]), threshold=0.3)
for result in results:
for score, label_id, box in zip(result["scores"], result["labels"], result["boxes"]):
score, label = score.item(), label_id.item()
box = [round(i, 2) for i in box.tolist()]
print(f"{model.config.id2label[label]}: {score:.2f} {box}")
```
## Kaynaklar
- Özel bir veri setinde [DeformableDetrForObjectDetection](/docs/transformers/main/tr/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) için çıkarım ve ince ayar yapmak üzere bu [defter](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Deformable-DETR) setine başvurun.
## DeformableDetrImageProcessor[[transformers.DeformableDetrImageProcessor]]
#### transformers.DeformableDetrImageProcessor[[transformers.DeformableDetrImageProcessor]]
```python
transformers.DeformableDetrImageProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L271)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'shortest_edge' : 800, 'longest_edge': 1333}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `2`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan değeri `[0.485, 0.456, 0.406]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.229, 0.224, 0.225]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
format (`str`, *kwargs*, *opsiyonel*, varsayılan `AnnotationFormat.COCO_DETECTION`) : Etiketlerin veri biçimi. "coco_detection" veya "coco_panoptic" değerlerinden biri.
do_convert_annotations (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Etiketlerin DEFORMABLE_DETR modelinin beklediği formata dönüştürülüp dönüştürülmeyeceğini kontrol eder. Sınırlayıcı kutuları `(center_x, center_y, width, height)` formatına ve `[0, 1]` aralığına dönüştürür. `preprocess` metodundaki `do_convert_annotations` parametresi ile geçersiz kılınabilir.
DeformableDetrImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.DeformableDetrImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L526)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
annotations (`AnnotationType` veya `list[AnnotationType]`, *isteğe bağlı*) : Görsellere uygulanan dolgu (padding) durumuna göre dönüştürülecek etiketler.
return_segmentation_masks (`bool`, *isteğe bağlı*, varsayılan `self.return_segmentation_masks`) : Segmentasyon maskelerinin döndürülüp döndürülmeyeceğini belirtir.
masks_path (`str` veya `pathlib.Path`, *isteğe bağlı*) : Segmentasyon maskelerini içeren dizinin yolu.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
format (`str`, *kwargs*, *opsiyonel*, varsayılan `AnnotationFormat.COCO_DETECTION`) : Etiketlerin veri biçimi. "coco_detection" veya "coco_panoptic" değerlerinden biri.
do_convert_annotations (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Etiketlerin DEFORMABLE_DETR modelinin beklediği formata dönüştürülüp dönüştürülmeyeceğini kontrol eder. Sınırlayıcı kutuları `(center_x, center_y, width, height)` formatına ve `[0, 1]` aralığına dönüştürür. `preprocess` metodundaki `do_convert_annotations` parametresi ile geçersiz kılınabilir.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
#### post_process_object_detection[[transformers.DeformableDetrImageProcessor.post_process_object_detection]]
```python
post_process_object_detection(outputs, threshold: float = 0.5, target_sizes: transformers.utils.generic.TensorType | list[tuple] = None, top_k: int = 100)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L667)
**Parametreler:**
outputs (`DetrObjectDetectionOutput`) : Modelin ham çıktıları.
threshold (`float`, *isteğe bağlı*) : Nesne algılama tahminlerini tutmak için skor eşiği.
target_sizes (`torch.Tensor` veya `list[tuple[int, int]]`, *isteğe bağlı*) : Şekli `(batch_size, 2)` olan bir Tensor veya batch'teki her bir görüntünün hedef boyutunu (yükseklik, genişlik) içeren tuple'ların (`tuple[int, int]`) listesi. None olarak bırakılırsa, tahminler yeniden boyutlandırılmaz.
top_k (`int`, *isteğe bağlı*, varsayılan 100) : Eşik ile filtrelemeden önce yalnızca en iyi k sınırlayıcı kutuyu korur.
**Dönüş:** `list[Dict]`
Bir sözlükler listesi; her sözlük, modelin tahminine göre bir batch içindeki bir görüntü için puanları, etiketleri ve kutuları içerir.
[DeformableDetrForObjectDetection](/docs/transformers/main/tr/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection)'ün ham çıktısını (top_left_x, top_left_y, bottom_right_x, bottom_right_y) biçiminde nihai sınırlayıcı kutulara dönüştürür. Yalnızca PyTorch desteklenir.
## DeformableDetrImageProcessorPil[[transformers.DeformableDetrImageProcessorPil]]
#### transformers.DeformableDetrImageProcessorPil[[transformers.DeformableDetrImageProcessorPil]]
```python
transformers.DeformableDetrImageProcessorPil(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L263)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'shortest_edge' : 800, 'longest_edge': 1333}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `2`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan değeri `[0.485, 0.456, 0.406]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.229, 0.224, 0.225]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
format (`str`, *kwargs*, *opsiyonel*, varsayılan `AnnotationFormat.COCO_DETECTION`) : Etiketlerin veri biçimi. "coco_detection" veya "coco_panoptic" değerlerinden biri.
do_convert_annotations (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Etiketlerin DEFORMABLE_DETR modelinin beklediği formata dönüştürülüp dönüştürülmeyeceğini kontrol eder. Sınırlayıcı kutuları `(center_x, center_y, width, height)` formatına ve `[0, 1]` aralığına dönüştürür. `preprocess` metodundaki `do_convert_annotations` parametresi ile geçersiz kılınabilir.
DeformableDetrImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.DeformableDetrImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L531)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
annotations (`AnnotationType` veya `list[AnnotationType]`, *isteğe bağlı*) : Görsellere uygulanan dolgu (padding) durumuna göre dönüştürülecek etiketler.
return_segmentation_masks (`bool`, *isteğe bağlı*, varsayılan `self.return_segmentation_masks`) : Segmentasyon maskelerinin döndürülüp döndürülmeyeceğini belirtir.
masks_path (`str` veya `pathlib.Path`, *isteğe bağlı*) : Segmentasyon maskelerini içeren dizinin yolu.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
format (`str`, *kwargs*, *opsiyonel*, varsayılan `AnnotationFormat.COCO_DETECTION`) : Etiketlerin veri biçimi. "coco_detection" veya "coco_panoptic" değerlerinden biri.
do_convert_annotations (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Etiketlerin DEFORMABLE_DETR modelinin beklediği formata dönüştürülüp dönüştürülmeyeceğini kontrol eder. Sınırlayıcı kutuları `(center_x, center_y, width, height)` formatına ve `[0, 1]` aralığına dönüştürür. `preprocess` metodundaki `do_convert_annotations` parametresi ile geçersiz kılınabilir.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
#### post_process_object_detection[[transformers.DeformableDetrImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs, threshold: float = 0.5, target_sizes: transformers.utils.generic.TensorType | list[tuple] = None, top_k: int = 100)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L676)
**Parametreler:**
outputs (`DetrObjectDetectionOutput`) : Modelin ham çıktıları.
threshold (`float`, *isteğe bağlı*) : Nesne algılama tahminlerini tutmak için skor eşiği.
target_sizes (`torch.Tensor` veya `list[tuple[int, int]]`, *isteğe bağlı*) : Şekli `(batch_size, 2)` olan bir Tensor veya batch'teki her bir görüntünün hedef boyutunu (yükseklik, genişlik) içeren tuple'ların (`tuple[int, int]`) listesi. None olarak bırakılırsa, tahminler yeniden boyutlandırılmaz.
top_k (`int`, *isteğe bağlı*, varsayılan 100) : Eşik ile filtrelemeden önce yalnızca en iyi k sınırlayıcı kutuyu korur.
**Dönüş:** `list[Dict]`
Bir sözlükler listesi; her sözlük, modelin tahminine göre bir batch içindeki bir görüntü için puanları, etiketleri ve kutuları içerir.
[DeformableDetrForObjectDetection](/docs/transformers/main/tr/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection)'ün ham çıktısını (top_left_x, top_left_y, bottom_right_x, bottom_right_y) biçiminde nihai sınırlayıcı kutulara dönüştürür. Yalnızca PyTorch desteklenir.
## DeformableDetrConfig[[transformers.DeformableDetrConfig]]
#### transformers.DeformableDetrConfig[[transformers.DeformableDetrConfig]]
```python
transformers.DeformableDetrConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_channels: int = 3, num_queries: int = 300, max_position_embeddings: int = 1024, encoder_layers: int = 6, encoder_ffn_dim: int = 1024, encoder_attention_heads: int = 8, decoder_layers: int = 6, decoder_ffn_dim: int = 1024, decoder_attention_heads: int = 8, encoder_layerdrop: float | int = 0.0, activation_function: str = 'relu', d_model: int = 256, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, init_std: float = 0.02, init_xavier_std: float = 1.0, return_intermediate: bool = True, auxiliary_loss: bool = False, position_embedding_type: str = 'sine', dilation: bool = False, num_feature_levels: int = 4, encoder_n_points: int = 4, decoder_n_points: int = 4, two_stage: bool = False, two_stage_num_proposals: int = 300, with_box_refine: bool = False, class_cost: int = 1, bbox_cost: int = 5, giou_cost: int = 2, mask_loss_coefficient: int = 1, dice_loss_coefficient: int = 1, bbox_loss_coefficient: int = 5, giou_loss_coefficient: int = 2, eos_coefficient: float = 0.1, focal_alpha: float = 0.25, disable_custom_kernels: bool = False, tie_word_embeddings: bool = True)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/configuration_deformable_detr.py#L25)
**Parametreler:**
is_encoder_decoder (`bool`, *isteğe bağlı*, varsayılan `True`) : Modelin bir kodlayıcı/çözücü olarak kullanılıp kullanılmadığı.
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Omurga modelinin yapılandırması.
num_channels (`int`, *opsiyonel*, varsayılan `3`) : Girdi kanal sayısı.
num_queries (`int`, *opsiyonel*, varsayılan 300) : Nesne sorgusu sayısı, yani algılama yuvaları. Bu, [DeformableDetrModel](/docs/transformers/main/tr/model_doc/deformable_detr#transformers.DeformableDetrModel)'in tek bir görüntüde algılayabileceği nesnelerin azami sayısıdır. `two_stage` `True` olarak ayarlanırsa, bunun yerine `two_stage_num_proposals` kullanılır.
max_position_embeddings (`int`, *isteğe bağlı*, varsayılan `1024`) : Bu modelin kullanılabileceği maksimum dizi uzunluğu.
encoder_layers (`int`, *isteğe bağlı*, varsayılan `6`) : Transformer kodlayıcısındaki gizli katman sayısı. Ayarlanmazsa `num_layers` ile aynı değeri kullanır.
encoder_ffn_dim (`int`, *opsiyonel*, varsayılan `1024`) : Kodlayıcıdaki "ara" (genellikle feed-forward olarak adlandırılan) katmanının boyutluluğu.
encoder_attention_heads (`int`, *isteğe bağlı*, varsayılan `8`) : Transformer kodlayıcısındaki her dikkat katmanı için dikkat başı sayısı.
decoder_layers (`int`, *isteğe bağlı*, varsayılan `6`) : Transformer decoder'ındaki gizli katman sayısı. Ayarlanmazsa `num_layers` ile aynı değer kullanılır.
decoder_ffn_dim (`int`, *isteğe bağlı*, varsayılan `1024`) : Dekoderdeki "ara" (genellikle feed-forward olarak adlandırılan) katmanın boyutluluğu.
decoder_attention_heads (`int`, *isteğe bağlı*, varsayılan `8`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
encoder_layerdrop (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Kodlayıcı için LayerDrop olasılığı. Daha fazla ayrıntı için [LayerDrop makalesine](see https://huggingface.co/papers/1909.11556) bakın.
activation_function (`str`, *isteğe bağlı*, varsayılan `relu`) : Dekoderdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
d_model (`int`, *isteğe bağlı*, varsayılan `256`) : Kodlayıcı katmanlarının ve havuzlayıcı katmanının boyutu.
dropout (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Tüm dropout katmanları için oran.
attention_dropout (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Dikkat olasılıkları için dropout oranı.
activation_dropout (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Tamamen bağlı katmandaki aktivasyonlar için dropout oranı.
init_std (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
init_xavier_std (`float`, *isteğe bağlı*, varsayılan `1.0`) : Çapraz dikkat ağırlıklarının Xavier başlatılmasında kullanılan ölçekleme faktörü.
return_intermediate (`bool`, *isteğe bağlı*, varsayılan True) : Ara durumun döndürülüp döndürülmeyeceği
auxiliary_loss (`bool`, *isteğe bağlı*, varsayılan `False`) : Yardımcı çözümleme kayıplarının (her decoder katmanındaki kayıplar) kullanılıp kullanılmayacağı.
position_embedding_type (`str`, *isteğe bağlı*, varsayılan `"sine"`) : Görüntü özelliklerinin üzerine kullanılacak konum gömme türü. `"sine"` veya `"learned"` değerlerinden biri.
dilation (`bool`, *isteğe bağlı*, varsayılan `False`) : Son konvolüsyon bloğunda (DC5) stride'ın dilation ile değiştirilip değiştirilmeyeceğini belirtir. Yalnızca `use_timm_backbone` = `True` olduğunda desteklenir.
num_feature_levels (`int`, *isteğe bağlı*, varsayılan 4) : Girdi özellik seviyelerinin sayısı.
encoder_n_points (`int`, *isteğe bağlı*, varsayılan 4) : Kodlayıcıdaki her dikkat başı için her özellik seviyesinde örneklenen anahtar sayısı.
decoder_n_points (`int`, *isteğe bağlı*, varsayılan 4) : Dekoderdeki her dikkat başı için her özellik seviyesinde örneklenen anahtar sayısı.
two_stage (`bool`, *isteğe bağlı*, varsayılan `False`) : Bölge önerilerinin de Deformable DETR'nin bir varyantı tarafından üretilip bunların daha sonra sınırlayıcı kutu (bounding box) ince ayarı için iteratif olarak dekodöre (decoder) gönderildiği iki aşamalı bir deformable DETR uygulanıp uygulanmayacağını belirtir.
two_stage_num_proposals (`int`, *isteğe bağlı*, varsayılan 300) : `two_stage` `True` olarak ayarlandığında oluşturulacak bölge önerilerinin sayısı.
with_box_refine (`bool`, *isteğe bağlı*, varsayılan `False`) : İteratif sınırlayıcı kutu iyileştirmesinin uygulanıp uygulanmayacağını belirtir; bu yöntemde her decoder katmanı, sınırlayıcı kutuları önceki katmandan gelen tahminlere göre iyileştirir.
class_cost (`int`, *opsiyonel*, varsayılan `1`) : Macar eşleştirme maliyetinde sınıflandırma hatasının göreli ağırlığı.
bbox_cost (`int`, *opsiyonel*, varsayılan `5`) : Macar eşleştirme maliyetinde L1 sınırlayıcı kutu hatasının göreli ağırlığı.
giou_cost (`int`, *opsiyonel*, varsayılan `2`) : Macar eşleştirme maliyetinde genelleştirilmiş IoU kaybının göreli ağırlığı.
mask_loss_coefficient (`int`, *opsiyonel*, varsayılan `1`) : Panoptik segmentasyon kaybında odak kaybının göreli ağırlığı.
dice_loss_coefficient (`int`, *isteğe bağlı*, varsayılan `1`) : Panoptik segmentasyon kaybında dice kaybının göreli ağırlığı.
bbox_loss_coefficient (`int`, *opsiyonel*, varsayılan `5`) : Panoptik segmentasyon kaybında L1 sınırlayıcı kutu kaybının göreli ağırlığı.
giou_loss_coefficient (`int`, *isteğe bağlı*, varsayılan `2`) : Panoptik segmentasyon kaybında genelleştirilmiş IoU kaybının göreli ağırlığı.
eos_coefficient (`float`, *opsiyonel*, varsayılan `0.1`) : Nesne algılama kaybında 'no-object' sınıfının göreli sınıflandırma ağırlığı.
focal_alpha (`float`, *isteğe bağlı*, varsayılan `0.25`) : Focal loss'taki Alpha parametresi.
disable_custom_kernels (`bool`, *isteğe bağlı*, varsayılan `False`) : Özel CUDA ve CPU çekirdeklerinin kullanımını devre dışı bırakır. Bu seçenek, özel çekirdeklerin PyTorch ONNX dışa aktarımı tarafından desteklenmediği için ONNX dışa aktarımı için gereklidir.
tie_word_embeddings (`bool`, *isteğe bağlı*, varsayılan `True`) : Ağırlık gömme bağlamalarının, modelin `tied_weights_keys` eşlemesine göre yapılıp yapılmayacağını belirtir.
Bu, bir DeformableDetrModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Deformable Detr modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, [SenseTime/deformable-detr](https://huggingface.co/SenseTime/deformable-detr) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnekler:
```python
>>> from transformers import DeformableDetrConfig, DeformableDetrModel
>>> # Initializing a Deformable DETR SenseTime/deformable-detr style configuration
>>> configuration = DeformableDetrConfig()
>>> # Initializing a model (with random weights) from the SenseTime/deformable-detr style configuration
>>> model = DeformableDetrModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## DeformableDetrModel[[transformers.DeformableDetrModel]]
#### transformers.DeformableDetrModel[[transformers.DeformableDetrModel]]
```python
transformers.DeformableDetrModel(config: DeformableDetrConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1145)
**Parametreler:**
config ([DeformableDetrConfig](/docs/transformers/main/tr/model_doc/deformable_detr#transformers.DeformableDetrConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde herhangi bir özel başlık olmadan ham gizli durumlar (hidden-states) üreten, bir omurga (backbone) ve kodlayıcı-çözücü (encoder-decoder) Transformer'dan oluşan çıplak Deformable DETR Modeli.
Bu model [PreTrainedModel](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.DeformableDetrModel.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1319)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri `image_processor_class` kullanılarak elde edilebilir. Ayrıntılar için `image_processor_class.__call__` bölümüne bakın (`processor_class`, görüntüleri işlemek için `image_processor_class` kullanır).
pixel_mask (`torch.LongTensor`, şekli `(batch_size, height, width)`, *isteğe bağlı*) : Dolgu piksel değerleri üzerinde dikkat işleminin uygulanmasını önlemek için maske. `[0, 1]` aralığında seçilen maske değerleri: - Gerçek (yani **maskelenmemiş**) pikseller için 1, - Dolgu (yani **maskelenmiş**) pikseller için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor`, şekli `(batch_size, num_queries)`, *isteğe bağlı*) : Varsayılan olarak kullanılmaz. Nesne sorgularını maskelemek için kullanılabilir.
encoder_outputs (`torch.Tensor`, *isteğe bağlı*) : (`last_hidden_state`, *isteğe bağlı*: `hidden_states`, *isteğe bağlı*: `attentions`) `last_hidden_state` boyutu `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) kodlayıcının son katmanının çıktısındaki gizli durumlar dizisidir. Çözücüdeki çapraz dikkat (cross-attention) işleminde kullanılır.
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : Düzleştirilmiş özellik haritasını (backbone + projeksiyon katmanının çıktısı) iletmek yerine, bir görüntünün düzleştirilmiş temsilini doğrudan iletme seçeneğine sahipsiniz.
decoder_inputs_embeds (`torch.Tensor`, şekli `(batch_size, num_queries, hidden_size)`, *isteğe bağlı*) : Sıfır tensörüyle sorguları başlatmak yerine, gömülü bir temsil doğrudan geçmeyi tercih edebilirsiniz.
**Dönüş:** `DeformableDetrModelOutput` veya `tuple(torch.Tensor)`
Bir `DeformableDetrModelOutput` veya bir `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırmaya (`None`) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[DeformableDetrModel](/docs/transformers/main/tr/model_doc/deformable_detr#transformers.DeformableDetrModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **init_reference_points** (`torch.Tensor`, şekli `(batch_size, num_queries, 4)`) -- Transformer decoder üzerinden gönderilen başlangıç referans noktaları.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, num_queries, hidden_size)`) -- Modelin decoder'ının son katmanının çıktısındaki gizli durumlar dizisi.
- **intermediate_hidden_states** (`torch.Tensor`, şekli `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- Yığılmış ara gizli durumlar (decoder'ın her katmanının çıktısı).
- **intermediate_reference_points** (`torch.Tensor`, şekli `(batch_size, config.decoder_layers, num_queries, 4)`) -- Yığılmış ara referans noktaları (decoder'ın her katmanının referans noktaları).
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, sequence_length, hidden_size)`.
Her katmanın çıktısında ve başlangıç gömme çıktılarında dekodlayıcının gizli durumları.
- **decoder_attentions** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat yumuşatma (attention softmax) sonrasında, öz-dikkat (self-attention) kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılan çözücü (decoder) dikkat ağırlıkları.
- **cross_attentions** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `(batch_size, num_heads, sequence_length, sequence_length)` biçiminde, her katman için bir adet içeren `torch.Tensor` demeti.
Dekoderin çapraz dikkat katmanının dikkat ağırlıkları, dikkat softmax'ından sonra, çapraz dikkat başlıklarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
- **encoder_last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) -- Modelin kodlayıcısının son katmanının çıktısındaki gizli durumlar dizisi.
- **encoder_hidden_states** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, sequence_length, hidden_size)`.
Her katmanın çıktısında ve başlangıç gömme çıktılarında kodlayıcının gizli durumları.
- **encoder_attentions** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat yumuşatma (attention softmax) sonrasında, öz-dikkat (self-attention) kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılan kodlayıcının dikkat ağırlıkları.
- **enc_outputs_class** (`torch.Tensor`, şekli `(batch_size, sequence_length, config.num_labels)`, *opsiyonel*, `config.with_box_refine=True` ve `config.two_stage=True` olduğunda döndürülür) -- İlk aşamada en yüksek `config.two_stage_num_proposals` puanlı sınırlayıcı kutuların bölge önerileri olarak seçildiği, tahmini sınırlayıcı kutu puanları. Sınırlayıcı kutu ikili sınıflandırmasının (yani ön plan ve arka plan) çıktısı.
- **enc_outputs_coord_logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, 4)`, *opsiyonel*, `config.with_box_refine=True` ve `config.two_stage=True` olduğunda döndürülür) -- Birinci aşamada tahmin edilen sınırlayıcı kutu koordinatlarının logitleri.
Örnekler:
```python
>>> from transformers import AutoImageProcessor, DeformableDetrModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
>>> model = DeformableDetrModel.from_pretrained("SenseTime/deformable-detr")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 300, 256]
```
## DeformableDetrForObjectDetection[[transformers.DeformableDetrForObjectDetection]]
#### transformers.DeformableDetrForObjectDetection[[transformers.DeformableDetrForObjectDetection]]
```python
transformers.DeformableDetrForObjectDetection(config: DeformableDetrConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1542)
**Parametreler:**
config ([DeformableDetrConfig](/docs/transformers/main/tr/model_doc/deformable_detr#transformers.DeformableDetrConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
COCO algılama gibi görevler için üstünde nesne algılama başlıkları bulunan, bir omurga ve kodlayıcı-çözücü Transformer'dan oluşan Deformable DETR Modeli.
Bu model [PreTrainedModel](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.DeformableDetrForObjectDetection.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, labels: list[dict] | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1580)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri `image_processor_class` kullanılarak elde edilebilir. Ayrıntılar için `image_processor_class.__call__` bölümüne bakın (`processor_class`, görüntüleri işlemek için `image_processor_class` kullanır).
pixel_mask (`torch.LongTensor`, şekli `(batch_size, height, width)`, *isteğe bağlı*) : Dolgu piksel değerleri üzerinde dikkat işleminin uygulanmasını önlemek için maske. `[0, 1]` aralığında seçilen maske değerleri: - Gerçek (yani **maskelenmemiş**) pikseller için 1, - Dolgu (yani **maskelenmiş**) pikseller için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor`, şekli `(batch_size, num_queries)`, *isteğe bağlı*) : Varsayılan olarak kullanılmaz. Nesne sorgularını maskelemek için kullanılabilir.
encoder_outputs (`torch.Tensor`, *isteğe bağlı*) : (`last_hidden_state`, *isteğe bağlı*: `hidden_states`, *isteğe bağlı*: `attentions`) `last_hidden_state` boyutu `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) kodlayıcının son katmanının çıktısındaki gizli durumlar dizisidir. Çözücüdeki çapraz dikkat (cross-attention) işleminde kullanılır.
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : Düzleştirilmiş özellik haritasını (backbone + projeksiyon katmanının çıktısı) iletmek yerine, bir görüntünün düzleştirilmiş temsilini doğrudan iletme seçeneğine sahipsiniz.
decoder_inputs_embeds (`torch.Tensor`, şekli `(batch_size, num_queries, hidden_size)`, *isteğe bağlı*) : Sıfır tensörüyle sorguları başlatmak yerine, gömülü bir temsil doğrudan geçmeyi tercih edebilirsiniz.
labels (`list[Dict]`, len `(batch_size,)`, *isteğe bağlı*) : İkili eşleştirme kaybını hesaplamak için etiketler. Sözlüklerden oluşan liste, her sözlük en azından şu 2 anahtarı içerir: 'class_labels' ve 'boxes' (sırasıyla bir batch içindeki bir görüntünün sınıf etiketleri ve sınırlayıcı kutuları). Sınıf etiketlerinin kendisi, len `(number of bounding boxes in the image,)` olan bir `torch.LongTensor` ve kutuların şekli `(number of bounding boxes in the image, 4)` olan bir `torch.Tensor` olmalıdır.
**Dönüş:** `DeformableDetrObjectDetectionOutput` veya `tuple(torch.Tensor)`
Bir `DeformableDetrObjectDetectionOutput` veya bir `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırmaya (`None`) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[DeformableDetrForObjectDetection](/docs/transformers/main/tr/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür)) -- Sınıf tahmini için negatif log-olabilirlik (çapraz entropi) ile sınırlayıcı kutu kaybının doğrusal bir kombinasyonu olarak toplam kayıp. İkincisi, L1 kaybı ve genelleştirilmiş ölçekten bağımsız IoU kaybının doğrusal bir kombinasyonu olarak tanımlanır.
- **loss_dict** (`Dict`, *isteğe bağlı*) -- Bireysel kayıpları içeren bir sözlük. Kayıt tutma için faydalıdır.
- **logits** (`torch.Tensor`, şekli `(batch_size, num_queries, num_classes + 1)`) -- Tüm sorgular için sınıflandırma logitleri (no-object dahil).
- **pred_boxes** (`torch.Tensor`, şekli `(batch_size, num_queries, 4)`) -- Tüm sorgular için normalize edilmiş kutu koordinatları, (center_x, center_y, width, height) olarak temsil edilir. Bu değerler, [0, 1] aralığında normalize edilmiştir ve parti içindeki her bir görüntünün boyutuna göre (olası dolguları göz ardı ederek) göreli olarak tanımlanır. Normalize edilmemiş sınırlayıcı kutuları almak için `~DeformableDetrProcessor.post_process_object_detection` işlevini kullanabilirsiniz.
- **auxiliary_outputs** (`list[Dict]`, *isteğe bağlı*) -- İsteğe bağlı, yalnızca yardımcı kayıplar etkinleştirildiğinde (yani `config.auxiliary_loss` `True` olarak ayarlandığında) ve etiketler sağlandığında döndürülür. Her kodlayıcı katmanı için yukarıdaki iki anahtarı (`logits` ve `pred_boxes`) içeren sözlüklerden oluşan bir listedir.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, num_queries, hidden_size)`, *isteğe bağlı*) -- Modelin decoder'ının son katmanının çıktısındaki gizli durumlar dizisi.
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, sequence_length, hidden_size)`.
Her katmanın çıktısında ve başlangıç gömme çıktılarında dekodlayıcının gizli durumları.
- **decoder_attentions** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat yumuşatma (attention softmax) sonrasında, öz-dikkat (self-attention) kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılan çözücü (decoder) dikkat ağırlıkları.
- **cross_attentions** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `(batch_size, num_heads, sequence_length, sequence_length)` biçiminde, her katman için bir adet içeren `torch.Tensor` demeti.
Dekoderin çapraz dikkat katmanının dikkat ağırlıkları, dikkat softmax'ından sonra, çapraz dikkat başlıklarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
- **encoder_last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) -- Modelin kodlayıcısının son katmanının çıktısındaki gizli durumlar dizisi.
- **encoder_hidden_states** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, sequence_length, hidden_size)`.
Her katmanın çıktısında ve başlangıç gömme çıktılarında kodlayıcının gizli durumları.
- **encoder_attentions** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat yumuşatma (attention softmax) sonrasında, öz-dikkat (self-attention) kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılan kodlayıcının dikkat ağırlıkları.
- **init_reference_points** (`torch.Tensor`, şekli `(batch_size, num_queries, 4)`) -- Transformer decoder üzerinden gönderilen başlangıç referans noktaları.
- **intermediate_hidden_states** (`torch.Tensor`, şekli `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- Yığılmış ara gizli durumlar (decoder'ın her katmanının çıktısı).
- **intermediate_reference_points** (`torch.Tensor`, şekli `(batch_size, config.decoder_layers, num_queries, 4)`) -- Yığılmış ara referans noktaları (decoder'ın her katmanının referans noktaları).
- **enc_outputs_class** (`torch.Tensor`, şekli `(batch_size, sequence_length, config.num_labels)`, *opsiyonel*, `config.with_box_refine=True` ve `config.two_stage=True` olduğunda döndürülür) -- İlk aşamada en yüksek `config.two_stage_num_proposals` puanlı sınırlayıcı kutuların bölge önerileri olarak seçildiği, tahmini sınırlayıcı kutu puanları. Sınırlayıcı kutu ikili sınıflandırmasının (yani ön plan ve arka plan) çıktısı.
- **enc_outputs_coord_logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, 4)`, *opsiyonel*, `config.with_box_refine=True` ve `config.two_stage=True` olduğunda döndürülür) -- Birinci aşamada tahmin edilen sınırlayıcı kutu koordinatlarının logitleri.
Örnekler:
```python
>>> from transformers import AutoImageProcessor, DeformableDetrForObjectDetection
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
>>> model = DeformableDetrForObjectDetection.from_pretrained("SenseTime/deformable-detr")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> target_sizes = torch.tensor([image.size[::-1]])
>>> results = image_processor.post_process_object_detection(outputs, threshold=0.5, target_sizes=target_sizes)[
... 0
... ]
>>> for score, label, box in zip(results["scores"], results["labels"], results["boxes"]):
... box = [round(i, 2) for i in box.tolist()]
... print(
... f"Detected {model.config.id2label[label.item()]} with confidence "
... f"{round(score.item(), 3)} at location {box}"
... )
Detected cat with confidence 0.8 at location [16.5, 52.84, 318.25, 470.78]
Detected cat with confidence 0.789 at location [342.19, 24.3, 640.02, 372.25]
Detected remote with confidence 0.633 at location [40.79, 72.78, 176.76, 117.25]
```