# InstructBlipVideo
## Genel Bakış
InstructBLIPVideo, Wenliang Dai, Junnan Li, Dongxu Li, Anthony Meng Huat Tiong, Junqi Zhao, Weisheng Wang, Boyang Li, Pascale Fung ve Steven Hoi tarafından önerilen [InstructBLIP: Towards General-purpose Vision-Language Models with Instruction Tuning](https://huggingface.co/papers/2305.06500) modellerinin bir uzantısıdır. InstructBLIPVideo, [InstructBLIP](instructblip) ile aynı mimariyi kullanır ve [InstructBLIP](instructblip) ile aynı kontrol noktalarıyla çalışır. Tek fark, video işleme yeteneğidir.
Makalenin özeti aşağıdaki gibidir:
*Çeşitli dil alanı görevlerini çözebilecek genel amaçlı dil modelleri, ön eğitim ve talimat ayarlama (instruction-tuning) hattının itici gücüyle ortaya çıkmıştır. Ancak, eklenen görsel girdi nedeniyle artan görev tutarsızlığı (task discrepancy) nedeniyle genel amaçlı görsel-dil modelleri geliştirmek zordur. Görsel-dil ön eğitimi yaygın olarak incelenmiş olsa da, görsel-dil talimat ayarlaması (instruction tuning) nispeten daha az keşfedilmiştir. Bu makalede, ön eğitilmiş BLIP-2 modelleri temel alınarak görsel-dil talimat ayarlaması üzerine sistematik ve kapsamlı bir çalışma yürütüyoruz. 26 farklı, kamuya açık veri setini derliyoruz, bunları talimat ayarlama formatına dönüştürüyor ve tutarlı (held-in) talimat ayarlaması ile tutarlı olmayan (held-out) sıfır atışlı (zero-shot) değerlendirme için iki küme olarak sınıflandırıyoruz. Ayrıca, modele verilen talimata göre bilgilendirici özellikler çıkarmasını sağlayan kritik bir yöntem olan talimat duyarlı görsel özellik çıkarımını (instruction-aware visual feature extraction) tanıtıyoruz. Sonuç olarak elde edilen InstructBLIP modelleri, tüm 13 tutarlı olmayan (held-out) veri setinde en iyi sıfır atışlı (state-of-the-art zero-shot) performansa ulaşmakta ve BLIP-2 ile daha büyük Flamingo modelini önemli ölçüde geride bırakmaktadır. Modellerimiz, bireysel aşağı akış (downstream) görevlerinde ayarlandığında (örneğin, ScienceQA IMG üzerinde %90,7 doğruluk) da en iyi performansa (state-of-the-art) yol açmaktadır. Bunun yanı sıra, InstructBLIP'in eş zamanlı çok modlu modellere (concurrent multimodal models) kıyasla avantajlarını nitel olarak gösteriyoruz.*
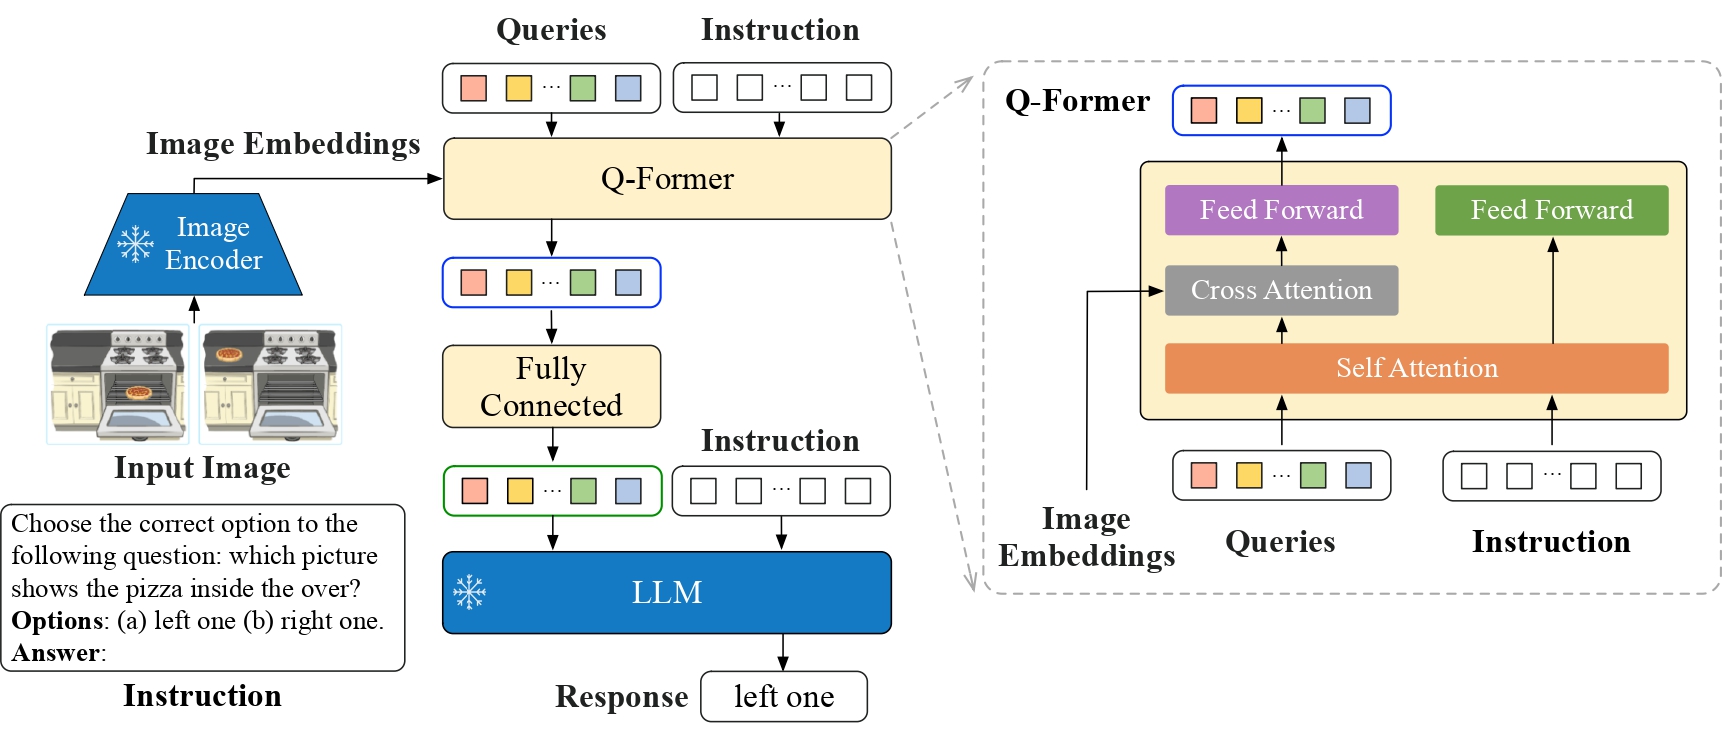 InstructBLIPVideo mimarisi. Orijinal makaleden alınmıştır.
Bu model [RaushanTurganbay](https://huggingface.co/RaushanTurganbay) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/salesforce/LAVIS/tree/main/projects/instructblip) bulunabilir.
## Kullanım ipuçları
- Model, video başına 4 kare örneklenerek eğitildiğinden, 4 kare örneklenmesi önerilir
> [!NOTE]
> v4.46 sürümünden sonra yayınlanan BLIP modelleri, `processor.num_query_tokens = {{num_query_tokens}}` eklenmesi ve model gömme katmanının özel `` jetonunu eklemek için genişletilmesi konusunda uyarılar verecektir. Model kontrol noktasının sahibi iseniz bu öznitelikleri işlemciye eklemeniz, sahibi değilseniz bir PR açmanız şiddetle önerilir. Bu öznitelikleri eklemek, BLIP'in her görsel için gereken sorgu jetonu sayısını ekleyeceği ve sorgu jetonu sayısı kadar `` yer tutucusuyla metni genişleteceği anlamına gelir. Genellikle görsel başına yaklaşık 500 jeton olduğundan, metnin kısaltılmadığından emin olun; aksi takdirde gömmelerin birleştirilmesi sırasında hata oluşacaktır.
Öznitelikler, model yapılandırmasından `model.config.num_query_tokens` olarak elde edilebilir ve model gömme genişletmesi [bu bağlantıyı](https://gist.github.com/zucchini-nlp/e9f20b054fa322f84ac9311d9ab67042) izleyerek yapılabilir.
## InstructBlipVideoConfig[[transformers.InstructBlipVideoConfig]]
#### transformers.InstructBlipVideoConfig[[transformers.InstructBlipVideoConfig]]
```python
transformers.InstructBlipVideoConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, qformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_query_tokens: int = 32, initializer_factor: float = 1.0, initializer_range: float = 0.02, video_token_index: int | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/configuration_instructblipvideo.py#L109)
**Parametreler:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Görüntü iskeletinin yapılandırma nesnesi veya sözlüğü.
qformer_config (`dict`, *isteğe bağlı*) : [InstructBlipVideoQFormerConfig](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoQFormerConfig) sınıfını başlatmak için kullanılan yapılandırma seçeneklerinin sözlüğü.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Metin omurgasının yapılandırma nesnesi veya sözlüğü.
num_query_tokens (`int`, *isteğe bağlı*, varsayılan 32) : Transformer'dan geçirilen sorgu belirteçlerinin sayısı.
initializer_factor (`float`, *opsiyonel*, varsayılan `1.0`) : Tüm ağırlık matrislerini başlatmak için kullanılan bir çarpan (1 olarak tutulmalıdır, başlatma testleri için dahili olarak kullanılır).
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
video_token_index (`int`, *isteğe bağlı*) : Girdi videoları için yer tutucu olarak kullanılan video jetonu indeksi.
Bu, bir InstructBlipVideoModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Instructblipvideo modelinin örneklenmesi ve model mimarisinin tanımlanması için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl) modelinin yapılandırmasına benzer bir yapılandırma elde edilmesini sağlar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import (
... InstructBlipVideoVisionConfig,
... InstructBlipVideoQFormerConfig,
... OPTConfig,
... InstructBlipVideoConfig,
... InstructBlipVideoForConditionalGeneration,
... )
>>> # Initializing a InstructBlipVideoConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVideoConfig()
>>> # Initializing a InstructBlipVideoForConditionalGeneration (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVideoForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a InstructBlipVideoConfig from a InstructBlipVideoVisionConfig, InstructBlipVideoQFormerConfig and any PreTrainedConfig
>>> # Initializing Instructblipvideo vision, Instructblipvideo Q-Former and language model configurations
>>> vision_config = InstructBlipVideoVisionConfig()
>>> qformer_config = InstructBlipVideoQFormerConfig()
>>> text_config = OPTConfig()
>>> config = InstructBlipVideoConfig(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
```
## InstructBlipVideoVisionConfig[[transformers.InstructBlipVideoVisionConfig]]
#### transformers.InstructBlipVideoVisionConfig[[transformers.InstructBlipVideoVisionConfig]]
```python
transformers.InstructBlipVideoVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 1408, intermediate_size: int = 6144, num_hidden_layers: int = 39, num_attention_heads: int = 16, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 14, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/configuration_instructblipvideo.py#L32)
**Parametreler:**
hidden_size (`int`, *isteğe bağlı*, varsayılan `1408`) : Gizli temsillerin boyutu.
intermediate_size (`int`, *isteğe bağlı*, varsayılan `6144`) : MLP temsillerinin boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `39`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `16`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
image_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `224`) : Her bir görüntünün boyutu (çözünürlüğü).
patch_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `14`) : Her yamanın boyutu (çözünürlüğü).
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-06`) : Katman normalizasyonu katmanlarında kullanılan epsilon.
attention_dropout (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Dikkat olasılıkları için dropout oranı.
initializer_range (`float`, *isteğe bağlı*, varsayılan `1e-10`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
qkv_bias (`bool`, *isteğe bağlı*, varsayılan `True`) : Sorgulara, anahtarlara ve değerlere bir sapma (bias) eklenip eklenmeyeceğini belirtir.
Bu, bir InstructBlipVideoModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Instructblipvideo modelinin örneklenmesi ve model mimarisinin tanımlanması için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl) modelinin yapılandırmasına benzer bir yapılandırma elde edilmesini sağlar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import InstructBlipVideoVisionConfig, InstructBlipVideoVisionModel
>>> # Initializing a InstructBlipVideoVisionConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVideoVisionConfig()
>>> # Initializing a InstructBlipVideoVisionModel (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVideoVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## InstructBlipVideoQFormerConfig[[transformers.InstructBlipVideoQFormerConfig]]
#### transformers.InstructBlipVideoQFormerConfig[[transformers.InstructBlipVideoQFormerConfig]]
```python
transformers.InstructBlipVideoQFormerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, cross_attention_frequency: int = 2, encoder_hidden_size: int = 1408)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/configuration_instructblipvideo.py#L67)
**Parametreler:**
vocab_size (`int`, *isteğe bağlı*, varsayılan `30522`) : Modelin sözlük boyutu. `input_ids` tarafından temsil edilebilecek farklı token sayısını tanımlar.
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
intermediate_size (`int`, *isteğe bağlı*, varsayılan `3072`) : MLP temsil boyutu.
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
hidden_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Gömme, kodlayıcı ve havuzlayıcıdaki tüm tam bağlı katmanlar için dropout olasılığı.
attention_probs_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Dikkat olasılıkları için dropout oranı.
max_position_embeddings (`int`, *isteğe bağlı*, varsayılan `512`) : Bu modelin kullanılabileceği maksimum dizi uzunluğu.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-12`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
pad_token_id (`int`, *isteğe bağlı*, varsayılan `0`) : Sözlükte dolgu için kullanılan token kimliği.
cross_attention_frequency (`int`, *isteğe bağlı*, varsayılan 2) : Transformer katmanlarına çapraz dikkat (cross-attention) eklenmesinin sıklığı.
encoder_hidden_size (`int`, *isteğe bağlı*, varsayılan 1408) : Çapraz dikkat için gizli durumların gizli boyutu.
Bu, bir InstructBlipVideoModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Instructblipvideo modelinin örneklenmesi ve model mimarisinin tanımlanması için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl) modelinin yapılandırmasına benzer bir yapılandırma elde edilmesini sağlar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnekler:
```python
>>> from transformers import InstructBlipVideoQFormerConfig, InstructBlipVideoQFormerModel
>>> # Initializing a InstructBlipVideo Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVideoQFormerConfig()
>>> # Initializing a model (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVideoQFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## InstructBlipVideoProcessor[[transformers.InstructBlipVideoProcessor]]
#### transformers.InstructBlipVideoProcessor[[transformers.InstructBlipVideoProcessor]]
```python
transformers.InstructBlipVideoProcessor(video_processor, tokenizer, qformer_tokenizer, num_query_tokens = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/processing_instructblipvideo.py#L35)
**Parametreler:**
video_processor (`InstructBlipVideoVideoProcessor`) : Video işleyici zorunlu bir girdidir.
tokenizer (`GPT2Tokenizer`) : Tokenizer zorunlu bir girdidir.
qformer_tokenizer (`AutoTokenizer`) : ['PreTrainedTokenizer`'] sınıfının bir örneği. Q-Former tokenizer'ı zorunlu bir girdidir.
num_query_tokens (`int`, *isteğe bağlı*) : Qformer'ın sorgu olarak kullandığı token sayısı, modelin yapılandırmasındakiyle aynı olmalıdır.
Bir video işleyiciyi, bir belirteç oluşturucuyu ve bir qformer belirteç oluşturucuyu tek bir işleyicide birleştiren bir InstructBlipVideoProcessor oluşturur.
[InstructBlipVideoProcessor](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoProcessor), [InstructBlipVideoVideoProcessor](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoVideoProcessor), [GPT2Tokenizer](/docs/transformers/v5.23.0/tr/model_doc/gpt2#transformers.GPT2Tokenizer) ve `{qformer_tokenizer_class}` sınıflarının tüm işlevlerini sunar. Daha fazla bilgi için [~InstructBlipVideoVideoProcessor](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoVideoProcessor), [~GPT2Tokenizer](/docs/transformers/v5.23.0/tr/model_doc/gpt2#transformers.GPT2Tokenizer) ve `~{qformer_tokenizer_class}` belgelerine bakın.
## InstructBlipVideoVideoProcessor[[transformers.InstructBlipVideoVideoProcessor]]
#### transformers.InstructBlipVideoVideoProcessor[[transformers.InstructBlipVideoVideoProcessor]]
```python
transformers.InstructBlipVideoVideoProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/video_processing_instructblipvideo.py#L30)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 384, 'width': 384}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `3`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.48145466, 0.4578275, 0.40821073]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.26862954, 0.26130258, 0.27577711]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
do_sample_frames (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : İşleme başlamadan önce videodan kare örneklenip örneklenmeyeceği veya videonun tamamının işleneceği.
video_metadata (`Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None]`, *kwargs*) : Toplam süre, fps ve toplam kare sayısı hakkında bilgi içeren videonun metadata'sı. Videodan kare örneklemek veya zaman damgalarını hesaplamak için kullanılacaktır. Videoyu işlemden önce manuel olarak çözmeye çalışmıyorsanız herhangi bir metadata geçirmeyin
fps (`Annotated[int | float | None, None]`, *kwargs*) : `do_sample_frames=True` olduğunda saniyede örneklenmesi hedeflenen kareler.
num_frames (`Annotated[int | None, None]`, *kwargs*) : `do_sample_frames=True` olduğunda örneklenmesi gereken maksimum kare sayısı.
return_metadata (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Video meta verilerinin döndürülüp döndürülmemesi. Video meta verileri, video süresi, fps, çözümleme arka ucu gibi bilgileri içeren bir nesnedir.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Ayarlanırsa, belirli bir çerçeveye ait tensörler döndürülür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: NumPy `np.ndarray` nesnelerini döndürür.
- ****kwargs** ([VideosKwargs](/docs/transformers/v5.23.0/tr/main_classes/processors#transformers.VideosKwargs), *opsiyonel*) : Her modallite (metin, görüntüler, videolar, ses) için ek işleme seçenekleri. Model-özel parametreler yukarıda listelenmiştir; desteklenen argümanların tam listesi için TypedDict sınıfına bakın.
InstructBlipVideoVideoProcessor video işleyicisi oluşturur.
#### preprocess[[transformers.InstructBlipVideoVideoProcessor.preprocess]]
```python
preprocess(videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]]], **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/video_processing_utils.py#L98)
**Parametreler:**
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`) : Ön işleme yapılacak video. Piksel değerleri 0 ile 255 arasında değişen tek bir video veya video partisi beklenir. Piksel değerleri 0 ile 1 arasında olan videolar geçiriliyorsa `do_rescale=False` olarak ayarlayın.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
do_sample_frames (`bool`, *kwargs*, *isteğe bağlı*) : İşleme başlamadan önce videodan kare örneklenip örneklenmeyeceği veya videonun tamamının işleneceği.
video_metadata (`Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None]`, *kwargs*) : Toplam süre, fps ve toplam kare sayısı hakkında bilgi içeren videonun metadata'sı. Videodan kare örneklemek veya zaman damgalarını hesaplamak için kullanılacaktır. Videoyu işlemden önce manuel olarak çözmeye çalışmıyorsanız herhangi bir metadata geçirmeyin
fps (`Annotated[int | float | None, None]`, *kwargs*) : `do_sample_frames=True` olduğunda saniyede örneklenmesi hedeflenen kareler.
num_frames (`Annotated[int | None, None]`, *kwargs*) : `do_sample_frames=True` olduğunda örneklenmesi gereken maksimum kare sayısı.
return_metadata (`bool`, *kwargs*, *isteğe bağlı*) : Video meta verilerinin döndürülüp döndürülmemesi. Video meta verileri, video süresi, fps, çözümleme arka ucu gibi bilgileri içeren bir nesnedir.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
## InstructBlipVideoVisionModel[[transformers.InstructBlipVideoVisionModel]]
#### transformers.InstructBlipVideoVisionModel[[transformers.InstructBlipVideoVisionModel]]
```python
transformers.InstructBlipVideoVisionModel(config: InstructBlipVideoVisionConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L394)
#### forward[[transformers.InstructBlipVideoVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L414)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri `image_processor_class` kullanılarak elde edilebilir. Ayrıntılar için `image_processor_class.__call__` bölümüne bakın ([InstructBlipVideoProcessor](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoProcessor), görüntü işleme için `image_processor_class` kullanır).
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya bir `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırmaya ([InstructBlipVideoConfig](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[InstructBlipVideoVisionModel](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoVisionModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
## InstructBlipVideoQFormerModel[[transformers.InstructBlipVideoQFormerModel]]
#### transformers.InstructBlipVideoQFormerModel[[transformers.InstructBlipVideoQFormerModel]]
```python
transformers.InstructBlipVideoQFormerModel(config: InstructBlipVideoQFormerConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L709)
InstructBlipVideo'da kullanılan Querying Transformer (Q-Former). BLIP-2'den hafifçe değiştirilmiştir çünkü talimatı da girdi olarak alır.
#### forward[[transformers.InstructBlipVideoQFormerModel.forward]]
```python
forward(input_ids: LongTensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, query_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L747)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`) : Sözlükteki girdi dizisi token'larının indeksleri. Varsayılan olarak dolgu (padding) yoksayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi ID'leri nelerdir?](../glossary#input-ids)
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
position_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdi dizisi token'larının konum gömme (position embeddings) içindeki konum indeksleri. `[0, config.n_positions - 1]` aralığında seçilir. [Konum kimlikleri (position IDs) nedir?](../glossary#position-ids)
query_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) : Dikkat (attention) hesabında kullanılacak gizli durumlar (hidden states). Çapraz dikkat (cross-attention) durumunda, sorgu (query) olarak kullanılacaktır (yani anahtar (key) ve değer (value), encoder_hidden_states kullanacaktır).
encoder_hidden_states (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : Kodlayıcının son katmanının çıktısındaki gizli durumlar dizisi. Model bir çözücü olarak yapılandırılmışsa çapraz dikkat (cross-attention) için kullanılır.
encoder_attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Kodlayıcı girdisindeki dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. Model bir çözücü (decoder) olarak yapılandırılmışsa bu maske, çapraz dikkat (cross-attention) için kullanılır. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0.
**Dönüş:** [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) veya `tuple(torch.Tensor)`
[BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırma ([InstructBlipVideoConfig](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[InstructBlipVideoQFormerModel](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoQFormerModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
- **cross_attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` ve `config.add_cross_attention=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `(batch_size, num_heads, sequence_length, sequence_length)` biçiminde, her katman için bir adet içeren `torch.Tensor` demeti.
Dekoderin çapraz dikkat katmanının dikkat ağırlıkları, dikkat softmax'ından sonra, çapraz dikkat başlıklarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
- **past_key_values** (`Cache`, *isteğe bağlı*, `use_cache=True` geçirildiğinde veya `config.use_cache=True` olduğunda döndürülür) -- Bir [Cache](/docs/transformers/v5.23.0/tr/internal/generation_utils#transformers.Cache) örneğidir. Daha fazla ayrıntı için [kv cache kılavuzumuza](https://huggingface.co/docs/transformers/en/kv_cache) bakın.
Sıralı çözümlemeyi hızlandırmak için (bkz. `past_key_values` girdisi) kullanılabilen, önceden hesaplanmış gizli durumları (self-attention bloklarındaki anahtar ve değerler ve isteğe bağlı olarak `config.is_encoder_decoder=True` ise cross-attention bloklarındaki anahtar ve değerler) içerir.
## InstructBlipVideoModel[[transformers.InstructBlipVideoModel]]
#### transformers.InstructBlipVideoModel[[transformers.InstructBlipVideoModel]]
```python
transformers.InstructBlipVideoModel(config: InstructBlipVideoConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L850)
**Parametreler:**
config ([InstructBlipVideoConfig](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine bakın.
Dil modeli, qformer ve görme kodlayıcıdan oluşan InstructBlipVideo taban Modeli.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.InstructBlipVideoModel.forward]]
```python
forward(pixel_values: Tensor, qformer_input_ids: Tensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, use_cache: bool | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L902)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri `image_processor_class` kullanılarak elde edilebilir. Ayrıntılar için `image_processor_class.__call__` bölümüne bakınız ([InstructBlipVideoProcessor](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoProcessor), görüntü işleme için `image_processor_class` kullanır).
qformer_input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Q-Former sözlüğündeki girdi dizisi belirteçlerinin (token) indeksleri. Girdi belirteçleri, Q-Former modelinin kodlayacağı bir metin istemi (prompt) olarak görev yapmak üzere isteğe bağlı olarak sağlanabilir. İndeksler [InstructBlipVideoProcessor](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoProcessor) kullanılarak elde edilebilir. Ayrıntılar için `InstructBlipVideoProcessor.__call__()` adresine bakın. [Girdi kimlikları (input IDs) nedir?](../glossary#input-ids)
qformer_attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
input_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi token'larının indeksleri. Dolgu (padding) varsayılan olarak yok sayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi ID'leri nelerdir?](../glossary#input-ids)
attention_mask (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor`, şekli `(batch_size, target_sequence_length)`, *isteğe bağlı*) : Sözlükte decoder giriş dizisi tokenlarının indeksleri. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)'a bakın. [Decoder giriş kimlikleri nelerdir?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor`, şekli `(batch_size, target_sequence_length)`, *isteğe bağlı*) : Varsayılan davranış: `decoder_input_ids` içindeki dolgu (pad) jetonlarını yok sayan bir tensör oluşturur. Varsayılan olarak nedensel maske (causal mask) de kullanılır. Yalnızca bir kodlayıcı-çözücü (encoder-decoder) dil modeli (T5 gibi) kullanıldığında geçerlidir.
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
use_cache (`bool`, *isteğe bağlı*) : `True` olarak ayarlanırsa, `past_key_values` anahtar değer durumları döndürülür ve çözümlemeyi hızlandırmak için kullanılabilir (bkz. `past_key_values`).
**Dönüş:** `InstructBlipVideoForConditionalGenerationModelOutput` veya `tuple(torch.Tensor)`
`InstructBlipVideoForConditionalGenerationModelOutput` veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([InstructBlipVideoConfig](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[InstructBlipVideoModel](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, *opsiyonel*, `labels` sağlandığında döndürülür, `torch.Tensor`, şekli `(1,)`) -- Dil modelinden gelen dil modelleme kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, config.vocab_size)`) -- Dil modelinin dil modelleme başlığının tahmin puanları.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *isteğe bağlı*) -- Görüntü kodlayıcısının çıktıları.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *isteğe bağlı*) -- Q-Former (Querying Transformer) çıktıları.
- **language_model_outputs** (`CausalLMOutputWithPast` veya `Seq2SeqLMOutput`) -- Dil modelinin çıktıları.
## InstructBlipVideoForConditionalGeneration[[transformers.InstructBlipVideoForConditionalGeneration]]
#### transformers.InstructBlipVideoForConditionalGeneration[[transformers.InstructBlipVideoForConditionalGeneration]]
```python
transformers.InstructBlipVideoForConditionalGeneration(config: InstructBlipVideoConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L1043)
**Parametreler:**
config ([InstructBlipVideoConfig](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine bakın.
Bir görüntü ve isteğe bağlı bir metin istemine (prompt) dayanarak metin üretmek için kullanılan InstructBlipVideo Modeli. Model, bir görme kodlayıcı (vision encoder), Sorgulama Dönüştürücüsü (Querying Transformer, Q-Former) ve bir dil modelinden oluşur.
Model isteğe bağlı olarak `input_ids` parametresi alabilir; bu parametre metin istemi (prompt) olarak görev yapar ve dil modelinin bu istemi devam ettirmesini sağlar. Aksi takdirde dil modeli, [BOS] (dizinin başlangıcı) token'ından başlayarak metin üretmeye başlar.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.InstructBlipVideoForConditionalGeneration.forward]]
```python
forward(pixel_values: Tensor, qformer_input_ids: Tensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, use_cache: bool | None = None, mm_encoder_outputs: transformers.modeling_outputs.BaseModelOutputWithPooling | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L1120)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri `image_processor_class` kullanılarak elde edilebilir. Ayrıntılar için `image_processor_class.__call__` bölümüne bakınız ([InstructBlipVideoProcessor](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoProcessor), görüntü işleme için `image_processor_class` kullanır).
qformer_input_ids (`torch.LongTensor` şekli (batch_size, sequence_length)) : Q-Former modülüne girdi olarak verilecek istem olarak kullanılan dizi.
qformer_attention_mask (`torch.LongTensor` şekli (batch_size, sequence_length), *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmaması için maske.
input_ids (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi token'larının indeksleri. Dolgu (padding) varsayılan olarak yok sayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi ID'leri nelerdir?](../glossary#input-ids)
attention_mask (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor`, şekli `(batch_size, target_sequence_length)`, *isteğe bağlı*) : Sözlükte decoder giriş dizisi tokenlarının indeksleri. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)'a bakın. [Decoder giriş kimlikleri nelerdir?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.LongTensor`, şekli `(batch_size, target_sequence_length)`, *isteğe bağlı*) : Belirli token indekslerinde dikkat işleminin uygulanmaması için maske. Varsayılan olarak, modelin geleceği tahmin ederken yalnızca önceki girdilere bakabilmesini sağlamak için nedensel bir maske kullanılır.
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
labels (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Maskeli dil modelleme kaybını hesaplamak için etiketler. Endeksler `[0, ..., config.vocab_size]` aralığında olmalı ya da -100 olmalı (`input_ids` docstring'ine bakın). Endeksleri `-100` olarak ayarlanan tokenlar yok sayılır (maskelenir), kayıp yalnızca `[0, ..., config.vocab_size]` aralığında etiketlere sahip tokenlar için hesaplanır.
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
use_cache (`bool`, *isteğe bağlı*) : `True` olarak ayarlanırsa, `past_key_values` anahtar değer durumları döndürülür ve çözümlemeyi hızlandırmak için kullanılabilir (bkz. `past_key_values`).
mm_encoder_outputs (`~modeling_outputs.BaseModelOutputWithPooling`, *isteğe bağlı*) : Anahtarları desteklenen modaliteler, değerleri ise o modalite için kodlanmış çıktılar olan bir Dict. Her kodlanmış çıktı, (`pooler_output`, *isteğe bağlı*: `last_hidden_states`, *isteğe bağlı*: `hidden_states`, *isteğe bağlı*: `attentions`) `pooler_output` `(batch_size, sequence_length, hidden_size)` boyutunda, *isteğe bağlı*) şeklindedir ve kodlayıcının çok modlu özelliklerinin metin gömme (embedding) ile birleştirilmiş bir dizisidir.
**Dönüş:** `InstructBlipVideoForConditionalGenerationModelOutput` veya `tuple(torch.Tensor)`
`InstructBlipVideoForConditionalGenerationModelOutput` veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([InstructBlipVideoConfig](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[InstructBlipVideoForConditionalGeneration](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoForConditionalGeneration) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, *opsiyonel*, `labels` sağlandığında döndürülür, `torch.Tensor`, şekli `(1,)`) -- Dil modelinden gelen dil modelleme kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, config.vocab_size)`) -- Dil modelinin dil modelleme başlığının tahmin puanları.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *isteğe bağlı*) -- Görüntü kodlayıcısının çıktıları.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *isteğe bağlı*) -- Q-Former (Querying Transformer) çıktıları.
- **language_model_outputs** (`CausalLMOutputWithPast` veya `Seq2SeqLMOutput`) -- Dil modelinin çıktıları.
Örnekler:
```python
>>> from transformers import InstructBlipVideoProcessor, InstructBlipVideoForConditionalGeneration
>>> import torch
>>> from huggingface_hub import hf_hub_download
>>> import av
>>> import numpy as np
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> model = InstructBlipVideoForConditionalGeneration.from_pretrained("Salesforce/instructblip-vicuna-7b", device_map="auto")
>>> processor = InstructBlipVideoProcessor.from_pretrained("Salesforce/instructblip-vicuna-7b")
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample uniformly 4 frames from the video
>>> total_frames = container.streams.video[0].frames
>>> indices = np.arange(0, total_frames, total_frames / 4).astype(int)
>>> clip = read_video_pyav(container, indices)
>>> prompt = "What is happening in the video?"
>>> inputs = processor(text=prompt, images=clip, return_tensors="pt").to(model.device)
>>> outputs = model.generate(
... **inputs,
... do_sample=False,
... num_beams=5,
... max_length=256,
... repetition_penalty=1.5,
... length_penalty=1.0,
... )
>>> generated_text = processor.batch_decode(outputs, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
"A person is eating a bowl of pasta, and they are using a fork to eat it. The person is sitting at a table, and the plate of pasta is on the table in front"
```
#### generate[[transformers.InstructBlipVideoForConditionalGeneration.generate]]
```python
generate(pixel_values: Tensor, qformer_input_ids: typing.Optional[torch.LongTensor] = None, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **generate_kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L1262)
**Parametreler:**
pixel_values (`torch.Tensor` şekli (batch_size, num_channels, height, width) veya : (batch_size, num_frames, num_channels, height, width)): İşlenecek girdi görüntüleri veya videoları.
qformer_input_ids (`torch.LongTensor` şekli (batch_size, sequence_length), *isteğe bağlı*) : Q-Former modülüne girdi olarak verilecek istem olarak kullanılan dizi.
qformer_attention_mask (`torch.LongTensor` şekli (batch_size, sequence_length), *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmaması için maske.
input_ids (`torch.LongTensor` şekli (batch_size, sequence_length), *isteğe bağlı*) : Üretim için istem (prompt) olarak kullanılan dizi.
attention_mask (`torch.LongTensor` şekli (batch_size, sequence_length), *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmaması için maske.
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) : Girdilerin gömülü temsili. float olmalı, int token değil.
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Görsel gömme konumsal kodlamasının enterpole edilecek olup olmayacağı.
**Dönüş:** `captions (list)`
batch_size * num_captions uzunluğunda bir dizi string.
Modelin koşullu bir üreteç olarak kullanılabilmesi için `generate` işlevini devre dışı bırakır.
#### get_video_features[[transformers.InstructBlipVideoForConditionalGeneration.get_video_features]]
```python
get_video_features(pixel_values: Tensor, qformer_input_ids: LongTensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L1332)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler.
qformer_input_ids (`torch.LongTensor` şekli (batch_size, sequence_length)) : Q-Former modülüne girdi olarak verilecek istem olarak kullanılan dizi.
qformer_attention_mask (`torch.LongTensor` şekli (batch_size, sequence_length), *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmaması için maske.
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** `BaseModelOutputWithVisionQformerOutputs` veya `tuple(torch.Tensor)`
A `BaseModelOutputWithVisionQformerOutputs` veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([InstructBlipVideoConfig](/docs/transformers/v5.23.0/tr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *isteğe bağlı*) -- Görüntü kodlayıcısının çıktıları.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *isteğe bağlı*) -- Q-Former (Querying Transformer) çıktıları.
Örnek:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, InstructBlipVideoForConditionalGeneration
>>> model = InstructBlipVideoForConditionalGeneration.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> processor = AutoProcessor.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```