# ViTMAE
[ViTMAE](https://huggingface.co/papers/2111.06377), bir görüntünün büyük bir bölümünü (~%75) maskeleyerek ön eğitimi yapılan, kendinden denetimli bir görme modelidir. Bir kodlayıcı, görünen görüntü yamalarını işler ve bir çözücü, eksik pikselleri kodlanmış yamalar ve maske jetonlarından yeniden oluşturur. Ön eğitimden sonra, kodlayıcı; görüntü sınıflandırma veya nesne algılama gibi aşağı akış görevlerinde yeniden kullanılabilir ve çoğu zaman denetimli öğrenme ile eğitilen modellerin performansını aşar.
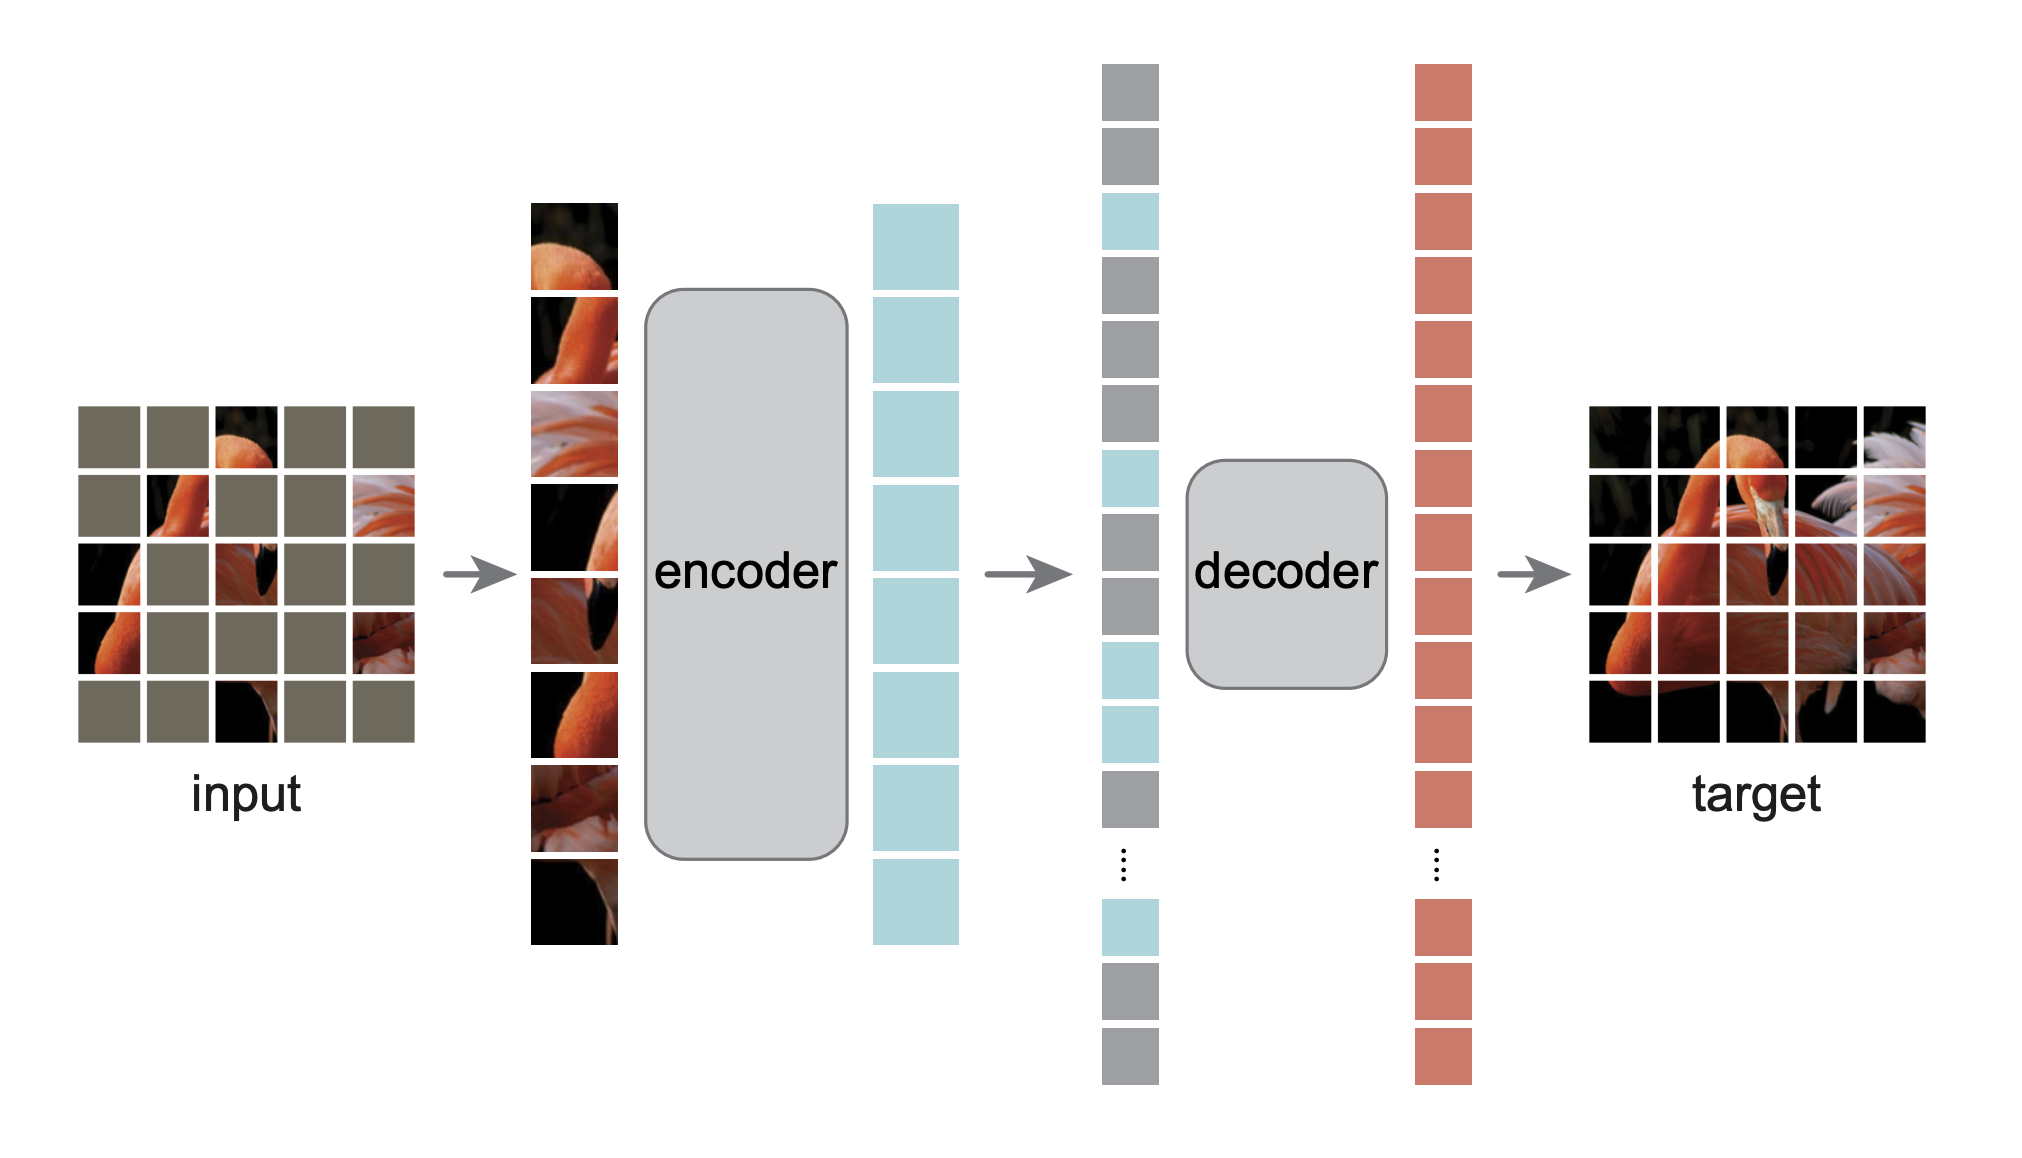 Tüm orijinal ViTMAE checkpoint'lerini [AI at Meta](https://huggingface.co/facebook?search_models=vit-mae) kuruluşu altında bulabilirsiniz.
> [!TIP]
> ViTMAE'nin görü görevlerine nasıl uygulanacağına dair daha fazla örnek için sağ kenar çubuğundaki ViTMAE modellerine tıklayın.
Aşağıdaki örnek, eksik piksellerin [ViTMAEForPreTraining](/docs/transformers/v5.23.0/tr/model_doc/vit_mae#transformers.ViTMAEForPreTraining) sınıfı ile nasıl yeniden oluşturulacağını göstermektedir.
```python
import requests
import torch
from PIL import Image
from transformers import ViTImageProcessor, ViTMAEForPreTraining
url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
processor = ViTImageProcessor.from_pretrained("facebook/vit-mae-base")
inputs = processor(image, return_tensors="pt").to(model.device)
inputs = {k: v.to(model.device) for k, v in inputs.items()}
model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base", attn_implementation="sdpa", device_map="auto")
with torch.no_grad():
outputs = model(**inputs)
reconstruction = outputs.logits
```
## Notlar
- ViTMAE genellikle iki aşamada kullanılır. [ViTMAEForPreTraining](/docs/transformers/v5.23.0/tr/model_doc/vit_mae#transformers.ViTMAEForPreTraining) ile kendiliğinden denetimli ön eğitim ve ardından dekoderin atılarak enkoderin ince ayarının yapılması. İnce ayarın ardından, ağırlıklar [ViTForImageClassification](/docs/transformers/v5.23.0/tr/model_doc/vit#transformers.ViTForImageClassification) gibi bir modele yerleştirilebilir.
- Girdi hazırlığı için [ViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/vit#transformers.ViTImageProcessor) kullanın.
## Kaynaklar
- [ViTMAEForPreTraining](/docs/transformers/v5.23.0/tr/model_doc/vit_mae#transformers.ViTMAEForPreTraining) ile yeniden oluşturulan pikselleri görselleştirmeyi öğrenmek için bu [notebook](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/ViTMAE/ViT_MAE_visualization_demo.ipynb)'a başvurun.
## ViTMAEConfig[[transformers.ViTMAEConfig]]
#### transformers.ViTMAEConfig[[transformers.ViTMAEConfig]]
```python
transformers.ViTMAEConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, qkv_bias: bool = True, decoder_num_attention_heads: int = 16, decoder_hidden_size: int = 512, decoder_num_hidden_layers: int = 8, decoder_intermediate_size: int = 2048, mask_ratio: float = 0.75, norm_pix_loss: bool = False)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/configuration_vit_mae.py#L24)
**Parametreler:**
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
intermediate_size (`int`, *isteğe bağlı*, varsayılan `3072`) : MLP temsil boyutu.
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
hidden_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Gömme, kodlayıcı ve havuzlayıcıdaki tüm tam bağlı katmanlar için dropout olasılığı.
attention_probs_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Dikkat olasılıkları için dropout oranı.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-12`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
image_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `224`) : Her bir görüntünün boyutu (çözünürlüğü).
patch_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `16`) : Her yamanın boyutu (çözünürlüğü).
num_channels (`int`, *opsiyonel*, varsayılan `3`) : Girdi kanal sayısı.
qkv_bias (`bool`, *isteğe bağlı*, varsayılan `True`) : Sorgulara, anahtarlara ve değerlere bir sapma (bias) eklenip eklenmeyeceğini belirtir.
decoder_num_attention_heads (`int`, *isteğe bağlı*, varsayılan `16`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
decoder_hidden_size (`int`, *isteğe bağlı*, varsayılan `512`) : Gizli temsillerin boyutu.
decoder_num_hidden_layers (`int`, *isteğe bağlı*, varsayılan 8) : Dekodördeki gizli katman sayısı.
decoder_intermediate_size (`int`, *isteğe bağlı*, varsayılan `2048`) : MLP temsillerinin boyutu.
mask_ratio (`float`, *opsiyonel*, varsayılan 0.75) : Girdi dizisindeki maskelenmiş token sayısının oranı.
norm_pix_loss (`bool`, *isteğe bağlı*, varsayılan `False`) : Normalize edilmiş piksellerle eğitim yapılıp yapılmayacağını belirtir (bkz. makaledeki Tablo 3). Yazarların deneylerinde normalize edilmiş piksellerin kullanılması temsil kalitesini artırmıştır.
Bu, bir ViTMAEModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Vit Mae modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılanlarla bir yapılandırma örneklendiğinde, [facebook/vit-mae-base](https://huggingface.co/facebook/vit-mae-base) ile benzer bir yapılandırma elde edilir.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import ViTMAEConfig, ViTMAEModel
>>> # Initializing a ViT MAE vit-mae-base style configuration
>>> configuration = ViTMAEConfig()
>>> # Initializing a model (with random weights) from the vit-mae-base style configuration
>>> model = ViTMAEModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ViTMAEModel[[transformers.ViTMAEModel]]
#### transformers.ViTMAEModel[[transformers.ViTMAEModel]]
```python
transformers.ViTMAEModel(config: ViTMAEConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/modeling_vit_mae.py#L614)
**Parametreler:**
config ([ViTMAEConfig](/docs/transformers/v5.23.0/tr/model_doc/vit_mae#transformers.ViTMAEConfig)) : Model yapılandırması.
Üzerinde herhangi bir özel başlık olmadan ham gizli durumları (hidden-states) üreten çıplak Vit Mae Modeli.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.ViTMAEModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/modeling_vit_mae.py#L628)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [ViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/vit#transformers.ViTImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın (`processor_class`, görüntüleri işlemek için [ViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/vit#transformers.ViTImageProcessor) kullanır).
noise (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Başlıca test amaçlı olarak kullanılır; rastgeleliği kontrol etmek ve yeniden üretilebilirliği korumak için
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun uygulanıp uygulanmayacağını belirtir. Bu, modelin daha yüksek çözünürlüklü görüntülerde kullanılabilmesi için başlıca olarak kullanılır.
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
**Dönüş:** `ViTMAEModelOutput` veya `tuple(torch.Tensor)`
Bir `ViTMAEModelOutput` veya bir `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırma ([ViTMAEConfig](/docs/transformers/v5.23.0/tr/model_doc/vit_mae#transformers.ViTMAEConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[ViTMAEModel](/docs/transformers/v5.23.0/tr/model_doc/vit_mae#transformers.ViTMAEModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **mask** (`torch.Tensor`, şekli `(batch_size, sequence_length)`) -- Hangi yamaların maskelendiğini (1) ve hangilerinin maskelenmediğini (0) gösteren tensör.
- **ids_restore** (`torch.LongTensor`, şekli `(batch_size, sequence_length)`) -- (karıştırılmış) maskelenmiş yamaların (patches) orijinal indeksini içeren tensör.
- **hidden_states** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren ve `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `(batch_size, num_heads, sequence_length, sequence_length)` biçiminde, her katman için bir adet içeren `torch.Tensor` demeti.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import AutoImageProcessor, ViTMAEModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEModel.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
#### transformers.ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
```python
transformers.ViTMAEForPreTraining(config: ViTMAEConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/modeling_vit_mae.py#L691)
**Parametreler:**
config ([ViTMAEConfig](/docs/transformers/v5.23.0/tr/model_doc/vit_mae#transformers.ViTMAEConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde self-supervised ön eğitim için decoder bulunan ViTMAE Model transformer'ı.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.ViTMAEForPreTraining.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/modeling_vit_mae.py#L790)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [ViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/vit#transformers.ViTImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın (`processor_class`, görüntüleri işlemek için [ViTImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/vit#transformers.ViTImageProcessor) kullanır).
noise (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Başlıca test amaçlı olarak kullanılır; rastgeleliği kontrol etmek ve yeniden üretilebilirliği korumak için
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun uygulanıp uygulanmayacağını belirtir. Bu, modelin daha yüksek çözünürlüklü görüntülerde kullanılabilmesi için başlıca olarak kullanılır.
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
**Dönüş:** `ViTMAEForPreTrainingOutput` veya `tuple(torch.Tensor)`
A `ViTMAEForPreTrainingOutput` veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırma ([ViTMAEConfig](/docs/transformers/v5.23.0/tr/model_doc/vit_mae#transformers.ViTMAEConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[ViTMAEForPreTraining](/docs/transformers/v5.23.0/tr/model_doc/vit_mae#transformers.ViTMAEForPreTraining) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`) -- Piksel yeniden oluşturma kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, patch_size ** 2 * num_channels)`) -- Piksel yeniden oluşturma logitsleri.
- **mask** (`torch.Tensor`, şekli `(batch_size, sequence_length)`) -- Hangi yamaların maskelendiğini (1) ve hangilerinin maskelenmediğini (0) gösteren tensör.
- **ids_restore** (`torch.LongTensor`, şekli `(batch_size, sequence_length)`) -- (karıştırılmış) maskelenmiş yamaların (patches) orijinal indeksini içeren tensör.
- **hidden_states** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren ve `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `(batch_size, num_heads, sequence_length, sequence_length)` biçiminde, her katman için bir adet içeren `torch.Tensor` demeti.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import AutoImageProcessor, ViTMAEForPreTraining
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> loss = outputs.loss
>>> mask = outputs.mask
>>> ids_restore = outputs.ids_restore
```