
Datasets documentation
将数据集共享到 Hub
将数据集共享到 Hub
Hub 汇集了丰富的社区精选及热门研究数据集。我们鼓励您将数据集分享至 Hub,以助力机器学习社区的发展,并加速所有人的研究进程。我们欢迎所有贡献;添加数据集只需拖放即可完成!
如果还没有,请先创建一个 Hugging Face Hub 账户。
通过 Hub UI 上传
Hub 的基于 Web 的界面允许没有任何开发经验的用户上传数据集。
创建仓库
仓库托管了您的所有数据集文件,包括修订历史记录,因此可以存储多个数据集版本。
- 点击您的个人资料,然后选择 New Dataset 以创建新的数据集仓库。
- 为你的数据集选择一个名称,并选择它是公开数据集还是私有数据集。公开数据集对所有人可见,而私有数据集只能由你或你所在组织的成员查看。

上传数据集
创建仓库后,前往 文件和版本 选项卡以添加文件。选择 添加文件 来上传您的数据集文件。我们支持许多文本、音频和图像数据扩展名,例如
.csv、.mp3和.jpg等。对于.csv、.json、.jsonl和.txt等文本数据扩展名,我们建议在上传到 Hub 之前先对其进行压缩(例如压缩为.zip或.gz文件扩展名)。文本文件扩展名默认不会被 Git LFS 跟踪,如果其大小超过 10MB,则无法提交和上传。请查看您仓库中的
.gitattributes文件,以获取完整的受跟踪文件扩展名列表。在本教程中,您可以使用以下小型示例.csv文件:train.csv、test.csv。
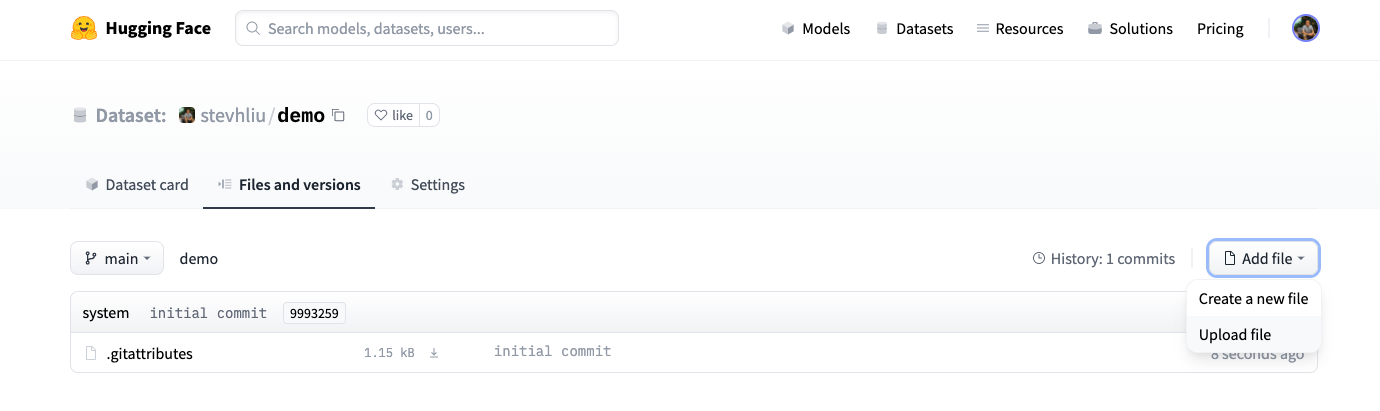
- 拖放您的数据集文件,并添加一条简短的描述性提交信息。
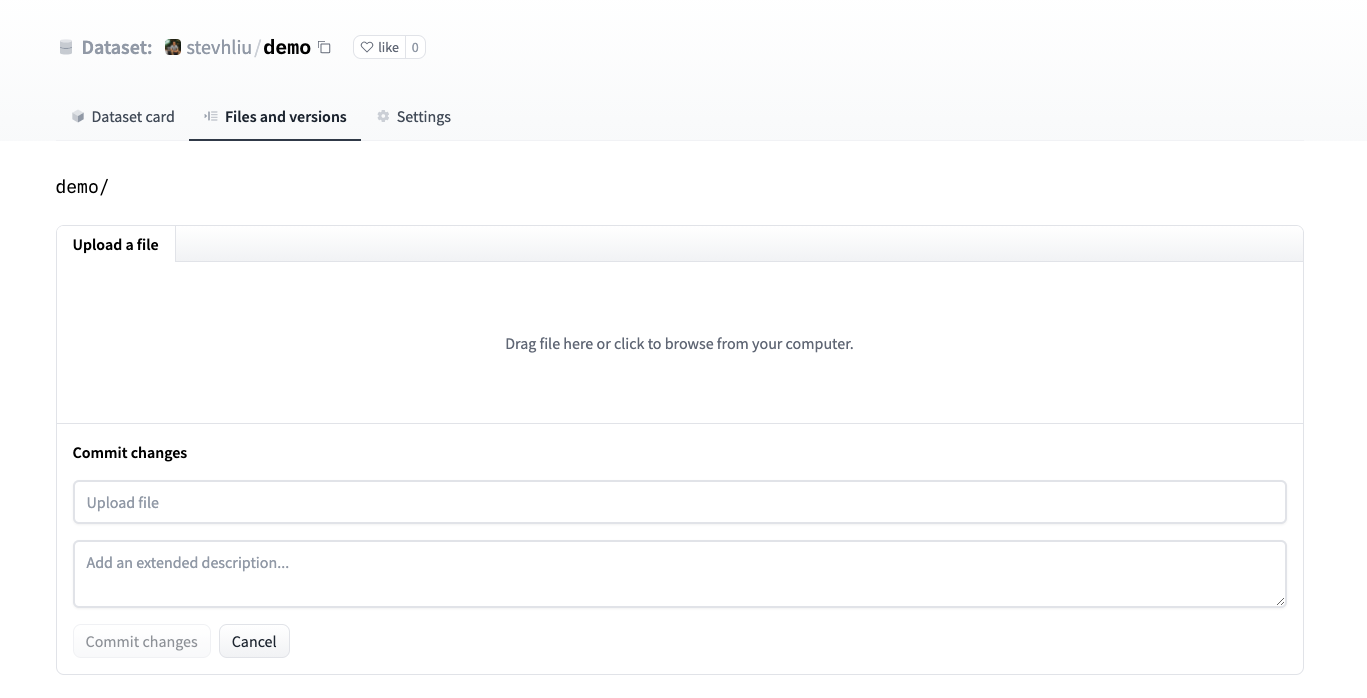
- 上传数据集文件后,它们将存储在你的数据集仓库中。

创建数据集卡片
添加数据集卡片对于帮助用户找到您的数据集并了解如何负责任地使用它非常有价值。
- 点击 创建数据集卡片 以创建数据集卡片。此按钮会在你的仓库中创建一个
README.md文件。

在顶部,您会看到元数据 UI,其中包含多个可供选择的字段,例如许可证、语言和任务类别。这些是帮助用户在 Hub 上发现您的数据集的最重要标签。当您从每个字段中选择一个选项时,它们会自动添加到数据集卡片的顶部。
您还可以查看 Dataset Card 规范,其中包含一组完整的(但非必需的)标签选项,例如
annotations_creators,以帮助您选择合适的标签。
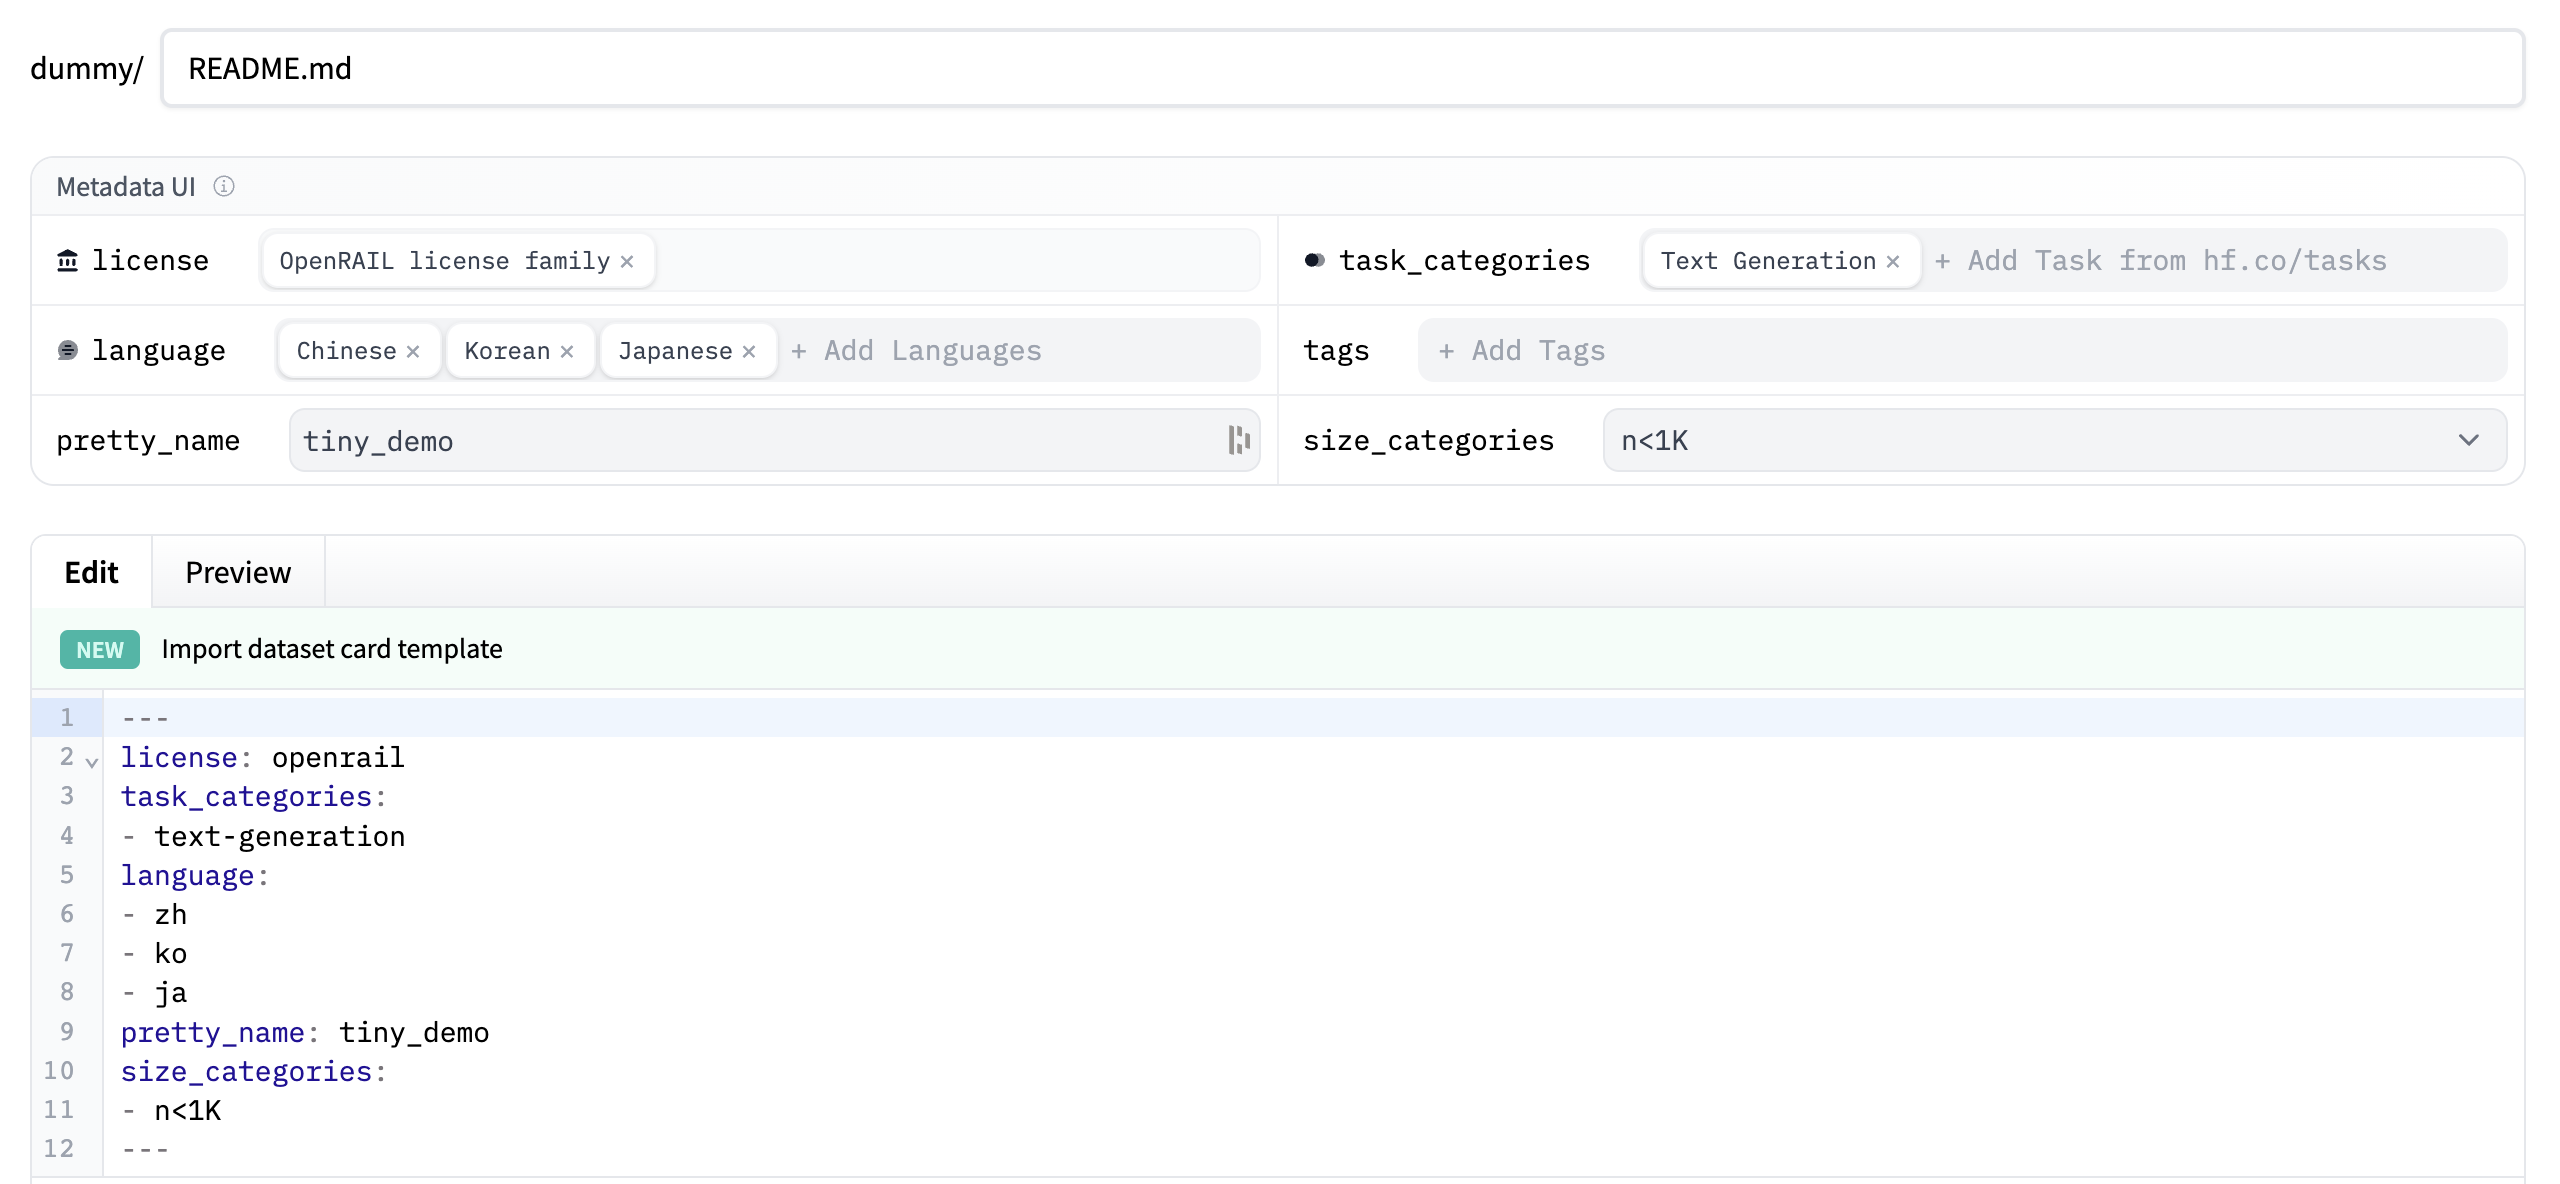
- 点击编辑器顶部的 Import dataset card template 链接,即可自动创建数据集卡片模板。填写该模板是向社区介绍数据集并帮助用户了解如何使用它的绝佳方式。如需查看优秀数据集卡片的详细示例,请参阅 CNN DailyMail Dataset card。
加载数据集
数据集存储到 Hub 后,任何人都可以使用 load_dataset() 函数加载它:
>>> from datasets import load_dataset

>>> dataset = load_dataset("stevhliu/demo")
使用 Python 上传
偏好以编程方式上传数据集的用户可以使用 huggingface_hub 库。该库允许用户通过 Python 与 Hub 进行交互。
- 首先安装该库:
pip install huggingface_hub
- 要在 Python 中将数据集上传到 Hub,您需要登录您的 Hugging Face 账户:
hf auth login
- 使用
push_to_hub()函数来帮助你添加、提交并推送文件到你的仓库:
>>> from datasets import load_dataset

>>> dataset = load_dataset("stevhliu/demo")
# dataset = dataset.map(...)  # do all your processing here
>>> dataset.push_to_hub("stevhliu/processed_demo")
要将数据集设置为私有,请将 private 参数设置为 True。此参数仅在你首次创建仓库时有效。
>>> dataset.push_to_hub("stevhliu/private_processed_demo", private=True)要将新的配置(或子集)添加到数据集,或添加新的拆分(train/validation/test),请参阅 Dataset.push_to_hub() 文档。
隐私
私有数据集仅对您可见。类似地,如果您在组织内共享数据集,则该组织的成员也可以访问该数据集。
通过向 token 参数提供身份验证令牌来加载私有数据集:
>>> from datasets import load_dataset

# Load a private individual dataset
>>> dataset = load_dataset("stevhliu/demo", token=True)

# Load a private organization dataset
>>> dataset = load_dataset("organization/dataset_name", token=True)
接下来是什么?
恭喜,你已完成教程!🥳
从这里,您可以继续:
- 了解如何使用 🤗 Datasets 的其他函数来处理您的数据集。
- 无需在本地下载即可流式传输大型数据集。
- 定义数据集的划分和配置,并与社区共享您的数据集。
如果您对 🤗 Datasets 有任何疑问,欢迎加入我们的论坛并向社区提问。
Update on GitHub