
Transformers documentation
CLIPSeg
Este modelo foi publicado no HF papers em 18/12/2021 e contribuído para o Hugging Face Transformers em 08/11/2022.
CLIPSeg
Visão geral
O modelo CLIPSeg foi proposto em Image Segmentation Using Text and Image Prompts por Timo Lüddecke e Alexander Ecker. O CLIPSeg adiciona um decodificador mínimo sobre um modelo CLIP congelado para segmentação de imagem zero-shot e one-shot.
O resumo do artigo é o seguinte:
A segmentação de imagens é geralmente abordada treinando um modelo para um conjunto fixo de classes de objetos. Incorporar classes adicionais ou consultas mais complexas posteriormente é caro, pois exige o re-treinamento do modelo em um conjunto de dados que abranja essas expressões. Aqui, propomos um sistema que pode gerar segmentações de imagens com base em prompts arbitrários no momento do teste. Um prompt pode ser um texto ou uma imagem. Essa abordagem nos permite criar um modelo unificado (treinado uma única vez) para três tarefas comuns de segmentação, que apresentam desafios distintos: segmentação de expressões referenciais, segmentação zero-shot e segmentação one-shot. Construímos sobre o modelo CLIP como backbone, que estendemos com um decodificador baseado em transformer que permite predição densa. Após o treinamento em uma versão estendida do conjunto de dados PhraseCut, nosso sistema gera um mapa de segmentação binário para uma imagem com base em um prompt de texto livre ou em uma imagem adicional que expressa a consulta. Analisamos em detalhes diferentes variantes dos prompts baseados em imagem. Essa nova entrada híbrida permite adaptação dinâmica não apenas às três tarefas de segmentação mencionadas acima, mas a qualquer tarefa de segmentação binária em que uma consulta de texto ou imagem possa ser formulada. Por fim, constatamos que nosso sistema se adapta bem a consultas generalizadas envolvendo affordances ou propriedades
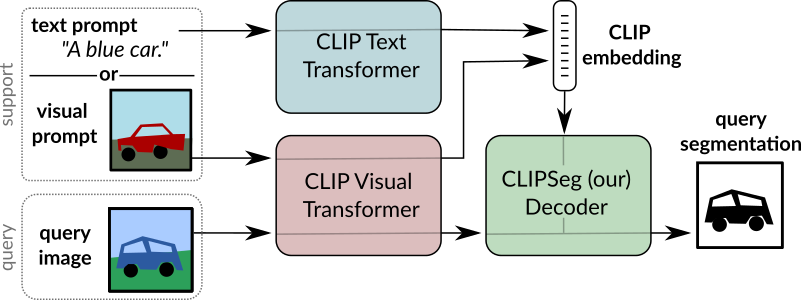 CLIPSeg overview. Taken from the original paper.
Este modelo foi contribuído por nielsr. O código original pode ser encontrado aqui.
Dicas de uso
- CLIPSegForImageSegmentation adiciona um decodificador sobre o CLIPSegModel. Este último é idêntico ao CLIPModel.
- CLIPSegForImageSegmentation pode gerar segmentações de imagem com base em prompts arbitrários no momento do teste. Um prompt pode ser um texto (fornecido ao modelo como
input_ids) ou uma imagem (fornecida ao modelo comoconditional_pixel_values). Também é possível fornecer embeddings condicionais personalizados (fornecidos ao modelo comoconditional_embeddings).
Recursos
Uma lista de recursos oficiais do Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o CLIPSeg. Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
- Um notebook que ilustra segmentação de imagem zero-shot com CLIPSeg.
CLIPSegConfig
classe transformers.CLIPSegConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonetext_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegTextConfig | None = Nonevision_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegVisionConfig | None = Noneprojection_dim: int | None = 512logit_scale_init_value: float | int | None = 2.6592initializer_factor: float | None = 1.0extract_layers: list[int] | tuple[int, ...] = (3, 6, 9)reduce_dim: int = 64decoder_num_attention_heads: int = 4decoder_attention_dropout: float | int = 0.0decoder_hidden_act: str = 'quick_gelu'decoder_intermediate_size: int = 2048conditional_layer: int = 0use_complex_transposed_convolution: bool = False )
Parâmetros
- text_config (
Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegTextConfig], opcional) — O objeto de configuração ou dicionário do backbone de texto. - vision_config (
Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegVisionConfig], opcional) — O objeto de configuração ou dicionário do backbone de visão. - projection_dim (
int, opcional, padrão512) — Dimensão das camadas de projeção de texto e visão. - logit_scale_init_value (
Union[float, int], opcional, padrão2.6592) — O valor inicial do parâmetro logit_scale. - initializer_factor (
float, opcional, padrão1.0) — Fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização). - extract_layers (
list[int], opcional, padrão[3, 6, 9]) — Camadas a serem extraídas ao encaminhar a imagem de consulta pelo backbone visual congelado do CLIP. - reduce_dim (
int, opcional, padrão 64) — Dimensão para reduzir o embedding de visão do CLIP. - decoder_num_attention_heads (
int, opcional, padrão4) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - decoder_attention_dropout (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as probabilidades de atenção. - decoder_hidden_act (
str, opcional, padrãoquick_gelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - decoder_intermediate_size (
int, opcional, padrão2048) — Dimensão das representações do MLP. - conditional_layer (
int, opcional, padrão 0) — A camada do codificador Transformer cujas ativações serão combinadas com os embeddings de condição usando FiLM (Feature-wise Linear Modulation). Se for 0, a última camada é utilizada. - use_complex_transposed_convolution (
bool, opcional, padrãoFalse) — Se deve usar uma convolução transposta mais complexa no decodificador, permitindo uma segmentação mais detalhada..
Esta é a classe de configuração para armazenar a configuração de um CLIPSegModel. Ela é usada para instanciar um modelo Clipseg de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do CIDAS/clipseg-rd64
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import CLIPSegConfig, CLIPSegModel

>>> # Initializing a CLIPSegConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegConfig()

>>> # Initializing a CLIPSegModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config

>>> # We can also initialize a CLIPSegConfig from a CLIPSegTextConfig and a CLIPSegVisionConfig

>>> # Initializing a CLIPSegText and CLIPSegVision configuration
>>> config_text = CLIPSegTextConfig()
>>> config_vision = CLIPSegVisionConfig()

>>> config = CLIPSegConfig(text_config=config_text, vision_config=config_vision)
CLIPSegTextConfig
classe transformers.CLIPSegTextConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 49408hidden_size: int = 512intermediate_size: int = 2048num_hidden_layers: int = 12num_attention_heads: int = 8max_position_embeddings: int = 77hidden_act: str = 'quick_gelu'layer_norm_eps: float | None = 1e-05attention_dropout: int | float | None = 0.0initializer_range: float = 0.02initializer_factor: float | None = 1.0pad_token_id: int | None = 1bos_token_id: int | None = 49406eos_token_id: int | list[int] | None = 49407 )
Parâmetros
- vocab_size (
int, opcional, padrão49408) — Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelosinput_ids. - hidden_size (
int, opcional, padrão512) — Dimensão das representações ocultas. - intermediate_size (
int, opcional, padrão2048) — Dimensão das representações do MLP. - num_hidden_layers (
int, opcional, padrão12) — Número de camadas ocultas no decodificador do Transformer. - num_attention_heads (
int, opcional, padrão8) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - max_position_embeddings (
int, opcional, padrão77) — O comprimento máximo de sequência com o qual este modelo pode ser utilizado. - hidden_act (
str, opcional, padrãoquick_gelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - layer_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização de camada. - attention_dropout (
Union[int, float], opcional, padrão0.0) — A taxa de dropout para as probabilidades de atenção. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - initializer_factor (
float, opcional, padrão1.0) — Fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização). - pad_token_id (
int, opcional, padrão1) — ID do token usado para preenchimento no vocabulário. - bos_token_id (
int, opcional, padrão49406) — ID do token usado para o início do fluxo no vocabulário. - eos_token_id (
Union[int, list[int]], opcional, padrão49407) — ID do token usado para o fim do fluxo no vocabulário.
Esta é a classe de configuração para armazenar a configuração de um CLIPSegModel. Ela é usada para instanciar um modelo Clipseg de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do CIDAS/clipseg-rd64
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import CLIPSegTextConfig, CLIPSegTextModel

>>> # Initializing a CLIPSegTextConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegTextConfig()

>>> # Initializing a CLIPSegTextModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegTextModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
CLIPSegVisionConfig
classe transformers.CLIPSegVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768intermediate_size: int = 3072num_hidden_layers: int = 12num_attention_heads: int = 12num_channels: int = 3image_size: int | list[int] | tuple[int, int] | None = 224patch_size: int | list[int] | tuple[int, int] | None = 32hidden_act: str = 'quick_gelu'layer_norm_eps: float = 1e-05attention_dropout: int | float | None = 0.0initializer_range: float = 0.02initializer_factor: float = 1.0 )
Parâmetros
- hidden_size (
int, opcional, padrão768) — Dimensão das representações ocultas. - intermediate_size (
int, opcional, padrão3072) — Dimensão das representações do MLP. - num_hidden_layers (
int, opcional, padrão12) — Número de camadas ocultas no decodificador do Transformer. - num_attention_heads (
int, opcional, padrão12) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - num_channels (
int, opcional, padrão3) — O número de canais de entrada. - image_size (
Union[int, list[int], tuple[int, int]], opcional, padrão224) — O tamanho (resolução) de cada imagem. - patch_size (
Union[int, list[int], tuple[int, int]], opcional, padrão32) — O tamanho (resolução) de cada patch. - hidden_act (
str, opcional, padrãoquick_gelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - layer_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização de camada. - attention_dropout (
Union[int, float], opcional, padrão0.0) — A taxa de dropout para as probabilidades de atenção. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - initializer_factor (
float, opcional, padrão1.0) — Fator para inicializar todas as matrizes de pesos (deve ser mantido em 1, usado internamente para testes de inicialização).
Esta é a classe de configuração para armazenar a configuração de um CLIPSegModel. Ela é usada para instanciar um modelo Clipseg de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do CIDAS/clipseg-rd64
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import CLIPSegVisionConfig, CLIPSegVisionModel

>>> # Initializing a CLIPSegVisionConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegVisionConfig()

>>> # Initializing a CLIPSegVisionModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
CLIPSegProcessor
classe transformers.CLIPSegProcessor
< source >( image_processor = Nonetokenizer = None**kwargs )
Constrói um CLIPSegProcessor que encapsula um processador de imagem e um tokenizador em um único processador.
CLIPSegProcessor oferece todas as funcionalidades de ViTImageProcessor e CLIPTokenizer. Consulte ~ViTImageProcessor e ~CLIPTokenizer para mais informações.
__call__
< source >( text = Noneimages = Nonevisual_prompt = None**kwargs ) → BatchEncoding
Parâmetros
- text (`
) -- The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, setis_split_into_words=True` to avoid ambiguity with batched inputs. - images (`
) -- Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, setdo_rescale=False`. - visual_prompt (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray],list[torch.Tensor]) — A imagem de prompt visual ou lote de imagens a ser preparada. Cada imagem de prompt visual pode ser uma imagem PIL, um array NumPy ou um tensor PyTorch. No caso de um array NumPy/tensor PyTorch, cada imagem deve ter a forma (C, H, W), onde C é o número de canais, e H e W são a altura e a largura da imagem. - return_tensors (
strou TensorType, opcional) — Se definido, retornará tensors de um framework específico. Os valores aceitos são:'pt': Retorna objetostorch.Tensordo PyTorch.'np': Retorna objetosnp.ndarraydo NumPy.
Retorna
Um BatchEncoding com os seguintes campos:
- input_ids — Lista de ids de tokens a serem fornecidos a um modelo. Retornado quando
textnão éNone. - attention_mask — Lista de índices que especifica quais tokens devem ser considerados pelo modelo (quando
return_attention_mask=Trueou se “attention_mask” estiver emself.model_input_namese setextnão forNone). - pixel_values — Valores de pixels a serem fornecidos a um modelo. Retornado quando
imagesnão éNone.
CLIPSegModel
classe transformers.CLIPSegModel
< source >( config: CLIPSegConfig )
Parâmetros
- config (CLIPSegConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo Clipseg básico, que gera os hidden-states brutos sem nenhum head específico no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonepixel_values: typing.Optional[torch.FloatTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonereturn_loss: bool | None = Noneinterpolate_pos_encoding: bool = True**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → CLIPSegOutput or tuple(torch.FloatTensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- pixel_values (
torch.FloatTensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando ViTImageProcessor. Consulte ViTImageProcessor.call() para mais detalhes (CLIPSegProcessor usa ViTImageProcessor para processar as imagens). - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - return_loss (
bool, opcional) — Se deve ou não retornar a perda contrastiva. - interpolate_pos_encoding (
bool, opcional, padrãoTrue) — Se deve interpolar as codificações de posição pré-treinadas.
Retorna
CLIPSegOutput ou tuple(torch.FloatTensor)
Um CLIPSegOutput ou uma tupla de
torch.FloatTensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (CLIPSegConfig) e das entradas.
O método forward do CLIPSegModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- loss (
torch.FloatTensorde forma(1,), opcional, retornado quandoreturn_losséTrue) — Perda contrastiva para similaridade entre imagem e texto. - logits_per_image (
torch.FloatTensorde forma(image_batch_size, text_batch_size)) — As pontuações de produto escalar normalizado entreimage_embedsetext_embeds. Isso representa as pontuações de similaridade entre imagem e texto. - logits_per_text (
torch.FloatTensorde forma(text_batch_size, image_batch_size)) — As pontuações do produto escalar normalizado entretext_embedseimage_embeds. Isso representa as pontuações de similaridade entre texto e imagem. - text_embeds (
torch.FloatTensorde forma(batch_size, output_dim) — Os embeddings de texto obtidos ao aplicar a camada de projeção à saída agregada do CLIPSegTextModel. - image_embeds (
torch.FloatTensorde forma(batch_size, output_dim) — Os embeddings de imagem obtidos ao aplicar a camada de projeção à saída agregada do CLIPSegVisionModel. - text_model_output (
~modeling_outputs.BaseModelOutputWithPooling, opcional) — A saída do CLIPSegTextModel. - vision_model_output (
~modeling_outputs.BaseModelOutputWithPooling, opcional) — A saída do CLIPSegVisionModel.
Exemplos:
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image

>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)

>>> inputs = processor(
...     text=["a photo of a cat", "a photo of a dog"], images=image, return_tensors="pt", padding=True
... )

>>> with torch.inference_mode():
...     outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image  # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1)  # we can take the softmax to get the label probabilities
get_text_features
< source >( input_ids: Tensorattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.FloatTensor)
Parâmetros
- input_ids (
torch.Tensorde formato(batch_size, sequence_length)) — Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1].
Retorna
BaseModelOutputWithPooling ou tuple(torch.FloatTensor)
Um BaseModelOutputWithPooling ou uma tupla de
torch.FloatTensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (CLIPSegConfig) e das entradas.
last_hidden_state (
torch.FloatTensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do modelo.pooler_output (
torch.FloatTensorde forma(batch_size, hidden_size)) — Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.hidden_states (
tuple(torch.FloatTensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.FloatTensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com formato(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.FloatTensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.FloatTensor(uma para cada camada) com a forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplos:
>>> import torch
>>> from transformers import AutoTokenizer, CLIPSegModel

>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")

>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
...     text_features = model.get_text_features(**inputs)
get_image_features
< source >( pixel_values: FloatTensorinterpolate_pos_encoding: bool = True**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.FloatTensor)
Parâmetros
- pixel_values (
torch.FloatTensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando ViTImageProcessor. Consulte ViTImageProcessor.call() para mais detalhes (CLIPSegProcessor usa ViTImageProcessor para processar imagens). - interpolate_pos_encoding (
bool, opcional, padrãoTrue) — Se deve interpolar as codificações de posição pré-treinadas.
Retorna
BaseModelOutputWithPooling ou tuple(torch.FloatTensor)
Um BaseModelOutputWithPooling ou uma tupla de
torch.FloatTensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (CLIPSegConfig) e das entradas.
last_hidden_state (
torch.FloatTensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do modelo.pooler_output (
torch.FloatTensorde forma(batch_size, hidden_size)) — Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.hidden_states (
tuple(torch.FloatTensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.FloatTensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com formato(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.FloatTensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.FloatTensor(uma para cada camada) com a forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplos:
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image

>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)

>>> inputs = processor(images=image, return_tensors="pt")

>>> with torch.inference_mode():
...     image_features = model.get_image_features(**inputs)
CLIPSegTextModel
classe transformers.CLIPSegTextModel
< source >( config: CLIPSegTextConfig )
Parâmetros
- config (CLIPSegTextConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo de texto do CLIPSEG, sem nenhum cabeçalho ou projeção no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.FloatTensor)
Parâmetros
- input_ids (
torch.Tensorde formato(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1].
Retorna
BaseModelOutputWithPooling ou tuple(torch.FloatTensor)
Um BaseModelOutputWithPooling ou uma tupla de
torch.FloatTensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (CLIPSegConfig) e das entradas.
O método forward do CLIPSegTextModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
last_hidden_state (
torch.FloatTensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do modelo.pooler_output (
torch.FloatTensorde forma(batch_size, hidden_size)) — Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.hidden_states (
tuple(torch.FloatTensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.FloatTensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com formato(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.FloatTensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.FloatTensor(uma para cada camada) com a forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplos:
>>> from transformers import AutoTokenizer, CLIPSegTextModel

>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegTextModel.from_pretrained("CIDAS/clipseg-rd64-refined")

>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")

>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output  # pooled (EOS token) states
CLIPSegVisionModel
classe transformers.CLIPSegVisionModel
< source >( config: CLIPSegVisionConfig )
Parâmetros
- config (CLIPSegVisionConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo de visão do CLIPSEG, sem nenhum cabeçalho ou projeção no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: typing.Optional[torch.FloatTensor]interpolate_pos_encoding: bool | None = True**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.FloatTensor)
Parâmetros
- pixel_values (
torch.FloatTensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando ViTImageProcessor. Consulte ViTImageProcessor.call() para mais detalhes (CLIPSegProcessor usa ViTImageProcessor para processar as imagens). - interpolate_pos_encoding (
bool, opcional, padrãoTrue) — Se deve interpolar as codificações de posição pré-treinadas.
Retorna
BaseModelOutputWithPooling ou tuple(torch.FloatTensor)
Um BaseModelOutputWithPooling ou uma tupla de
torch.FloatTensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (CLIPSegConfig) e das entradas.
O método forward do CLIPSegVisionModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
last_hidden_state (
torch.FloatTensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do modelo.pooler_output (
torch.FloatTensorde forma(batch_size, hidden_size)) — Estado oculto da última camada do primeiro token da sequência (token de classificação) após processamento adicional pelas camadas usadas para a tarefa de pré-treinamento auxiliar. Por exemplo, para modelos da família BERT, isso retorna o token de classificação após o processamento por uma camada linear e uma função de ativação tanh. Os pesos da camada linear são treinados a partir do objetivo de previsão da próxima frase (classificação) durante o pré-treinamento.hidden_states (
tuple(torch.FloatTensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.FloatTensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) com formato(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.FloatTensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.FloatTensor(uma para cada camada) com a forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplos:
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> from transformers import AutoProcessor, CLIPSegVisionModel

>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegVisionModel.from_pretrained("CIDAS/clipseg-rd64-refined")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> inputs = processor(images=image, return_tensors="pt")

>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output  # pooled CLS states
CLIPSegForImageSegmentation
classe transformers.CLIPSegForImageSegmentation
< source >( config: CLIPSegConfig )
Parâmetros
- config (CLIPSegConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo CLIPSeg com um decodificador baseado em Transformer no topo para segmentação de imagem zero-shot e one-shot.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.FloatTensor] = Nonepixel_values: typing.Optional[torch.FloatTensor] = Noneconditional_pixel_values: typing.Optional[torch.FloatTensor] = Noneconditional_embeddings: typing.Optional[torch.FloatTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonelabels: typing.Optional[torch.FloatTensor] = Noneinterpolate_pos_encoding: bool = True**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → CLIPSegOutput or tuple(torch.FloatTensor)
Parâmetros
- input_ids (
torch.FloatTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O preenchimento (padding) será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- pixel_values (
torch.FloatTensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando ViTImageProcessor. Consulte ViTImageProcessor.call() para mais detalhes (CLIPSegProcessor usa ViTImageProcessor para processar as imagens). - conditional_pixel_values (
torch.FloatTensor, opcional) — Os valores de pixel das imagens condicionais. - conditional_embeddings (
torch.FloatTensorde forma(batch_size, config.projection_dim), opcional) — Os embeddings condicionais para as imagens de consulta. Se fornecidos, o modelo usará esses em vez de calcular os embeddings a partir de conditional_pixel_values. - attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - labels (
torch.FloatTensorde forma(batch_size, height, width), opcional) — Máscaras de segmentação de referência, com valores em[0, 1]e o mesmo tamanho espacial quelogits. Uma perda de entropia cruzada binária é calculada entre os logits previstos e essas máscaras. - interpolate_pos_encoding (
bool, opcional, padrãoTrue) — Se deve interpolar as codificações de posição pré-treinadas.
Retorna
CLIPSegOutput ou tuple(torch.FloatTensor)
Um CLIPSegOutput ou uma tupla de
torch.FloatTensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (CLIPSegConfig) e das entradas.
O método forward de CLIPSegForImageSegmentation substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- loss (
torch.FloatTensorde forma(1,), opcional, retornado quandoreturn_losséTrue) — Perda contrastiva para similaridade entre imagem e texto. - logits_per_image (
torch.FloatTensorde forma(image_batch_size, text_batch_size)) — As pontuações de produto escalar normalizado entreimage_embedsetext_embeds. Isso representa as pontuações de similaridade entre imagem e texto. - logits_per_text (
torch.FloatTensorde forma(text_batch_size, image_batch_size)) — As pontuações do produto escalar normalizado entretext_embedseimage_embeds. Isso representa as pontuações de similaridade entre texto e imagem. - text_embeds (
torch.FloatTensorde forma(batch_size, output_dim) — Os embeddings de texto obtidos ao aplicar a camada de projeção à saída agregada do CLIPSegTextModel. - image_embeds (
torch.FloatTensorde forma(batch_size, output_dim) — Os embeddings de imagem obtidos ao aplicar a camada de projeção à saída agregada do CLIPSegVisionModel. - text_model_output (
~modeling_outputs.BaseModelOutputWithPooling, opcional) — A saída do CLIPSegTextModel. - vision_model_output (
~modeling_outputs.BaseModelOutputWithPooling, opcional) — A saída do CLIPSegVisionModel.
Exemplos:
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegForImageSegmentation
>>> from transformers.image_utils import load_image

>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegForImageSegmentation.from_pretrained("CIDAS/clipseg-rd64-refined")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)

>>> texts = ["a cat", "a remote", "a blanket"]
>>> inputs = processor(text=texts, images=[image] * len(texts), padding=True, return_tensors="pt")

>>> with torch.inference_mode():
...     outputs = model(**inputs)

>>> logits = outputs.logits
>>> print(logits.shape)
torch.Size([3, 352, 352])